읽는 시간 약 8분
먼저 답하면: 자연어 데이터 분석을 계속 맡길지 판단할 때는 쿼리 총액만 보지 마세요. 질문별 실행 식별자, 관측 가능한 비용·지연, 실패·재시도, 사람의 검증·수정, 다음 결정을 한 장의 원장에 함께 남겨야 합니다.
AI 데이터 에이전트에 “지난주 매출이 왜 줄었나요?”라고 물었을 때 답변이 그럴듯해도, 같은 질문이 반복될수록 재시도와 수정이 늘어난다면 그 위임은 다시 살펴봐야 합니다. 이 글에서는 탐색성 질문과 반복 위임 질문을 나누고, 어떤 질문을 유지·축소·중단·수정할지 결정하는 질문별 실행 원장 6칸을 정리합니다.
핵심 요약
- 한 달의 총 사용액은 출발점일 뿐이며, 질문 단위의 실행 기록이 있어야 위임 범위를 조정할 수 있습니다.
- 측정할 수 없는 비용은 억지로 배분하지 말고 unknown으로 남겨야 다음 측정 설계가 선명해집니다.
- 낮은 비용이라도 검증 실패와 사람 재작업이 줄지 않으면 자동 확대하지 않는 편이 안전합니다.
- 처음에는 읽기 전용 질문 하나로 시범 운영하고, 관측 가능한 결과를 쌓은 뒤 범위를 넓히는 것이 좋습니다.
왜 쿼리 총액만으로는 부족할까요?
자연어로 데이터를 묻는 도구와 데이터 에이전트는 데이터 탐색의 진입 장벽을 낮춥니다. Google Cloud의 Conversational analytics 문서는 검증된 질의와 에이전트 맥락·지침을 다루고, 데이터 에이전트 생성 문서는 구성과 운영의 출발점을 제공합니다. 다만 문서가 있다고 해서 모든 질문을 같은 방식으로 위임할 수 있다는 뜻은 아닙니다.
예를 들어 한 번만 탐색하는 질문은 약간의 사람 확인을 감수할 수 있습니다. 반면 매주 반복되는 보고 질문은 작은 해석 오류나 재시도가 누적됩니다. 비용은 처리량만이 아니라 다시 묻는 시간, 검토자가 고친 시간, 답변을 신뢰할 수 없어 중단한 횟수에서도 발생합니다.
질문별 실행 원장 6칸: 모르는 값도 기록합니다
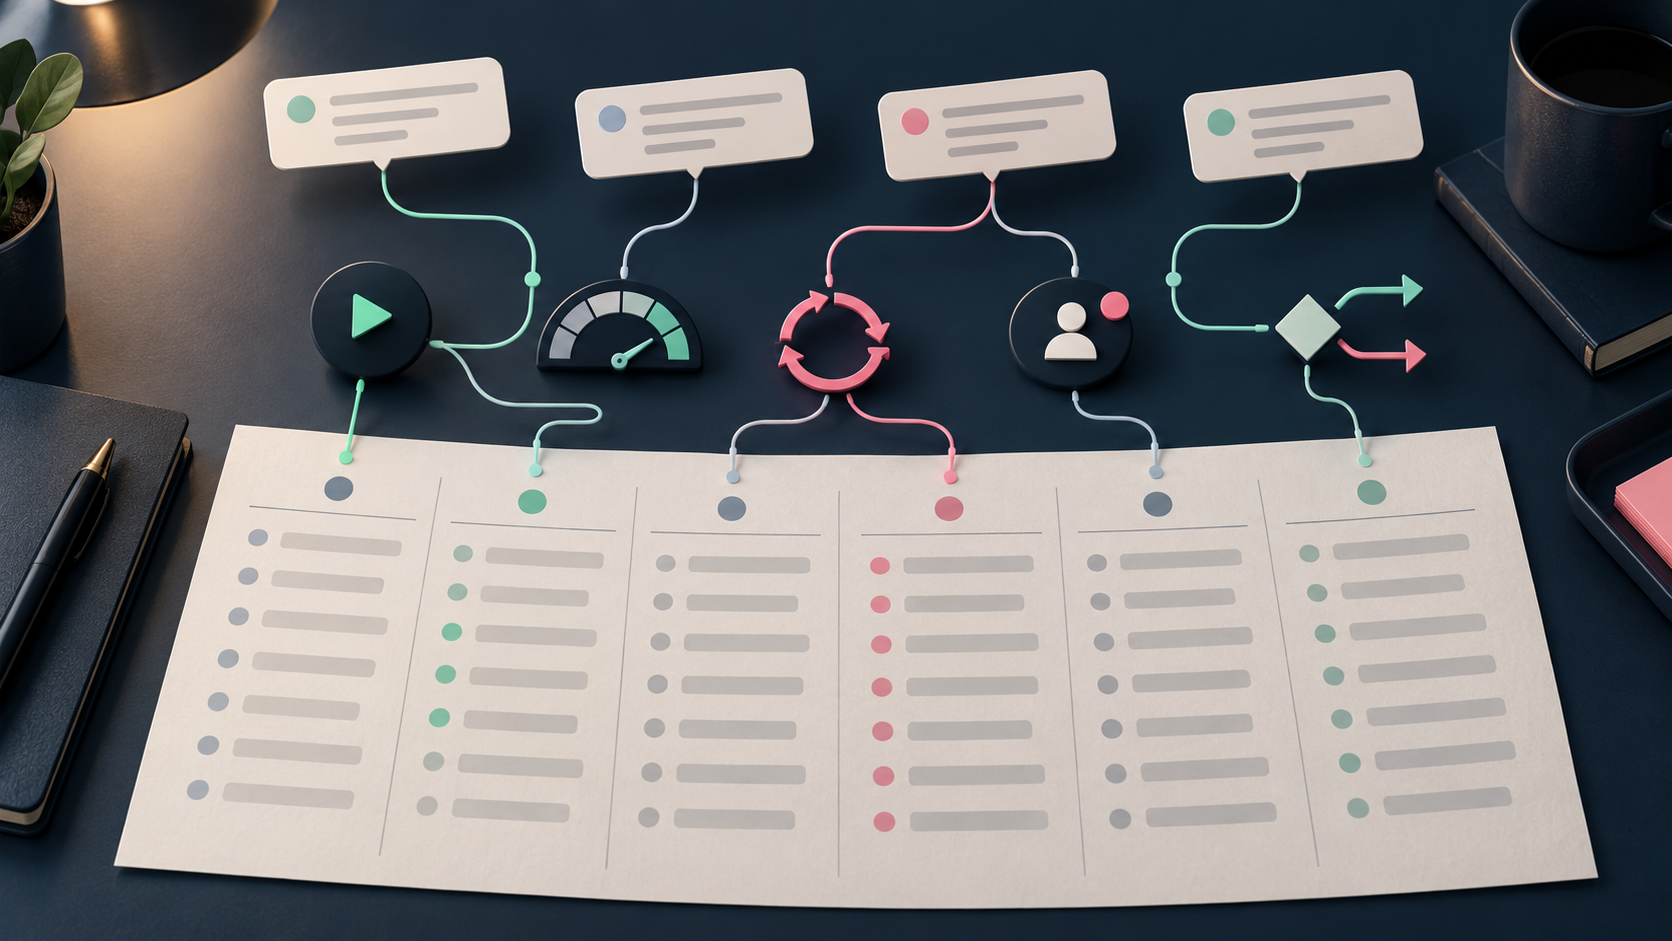
원장은 복잡한 회계 시스템이 아닙니다. 한 줄이 한 질문 유형을 대표하도록 정하고, 같은 유형의 실행을 누적해 다음 결정을 돕는 운영 표입니다.
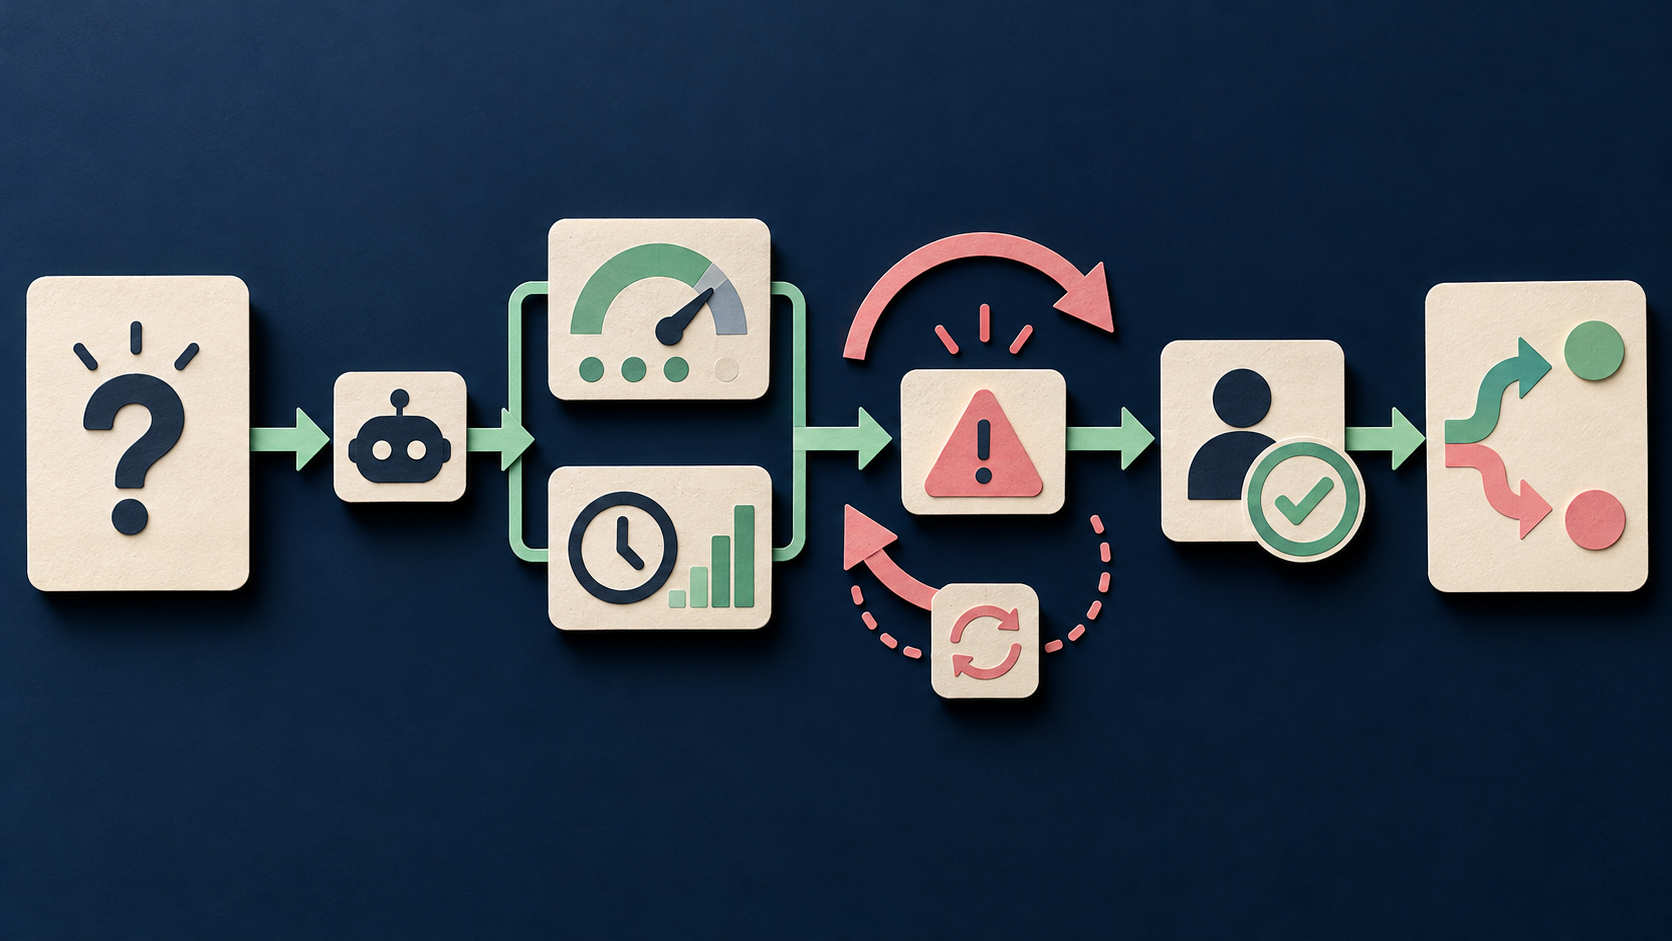
- 질문 유형·업무 목적: “지난주 매출 하락 이유”처럼 문장을 적고, 일회 탐색인지 반복 보고인지 표시합니다.
- 실행 식별자: 실행을 다시 찾을 수 있는 run ID, 요청 시각 또는 재현 가능한 링크를 남깁니다.
- 관측값: 확보 가능한 비용, 스캔량, 지연을 기록합니다. 상세 사용량 내보내기 문서처럼 자원 수준 정보를 제공하는 경로가 있어도 질문 단위 귀속이 안 되면 unknown으로 표시합니다.
- 실패·재시도·중단: 빈 답, 권한 거절, 도구 오류, 재질문을 횟수와 이유로 남깁니다.
- 사람 검증·수정: 확인만 했는지, 숫자·기간·해석을 고쳤는지 구분합니다.
- 다음 위임 결정: 유지, 축소, 중단, 질문 템플릿 수정 중 하나와 근거를 함께 적습니다.
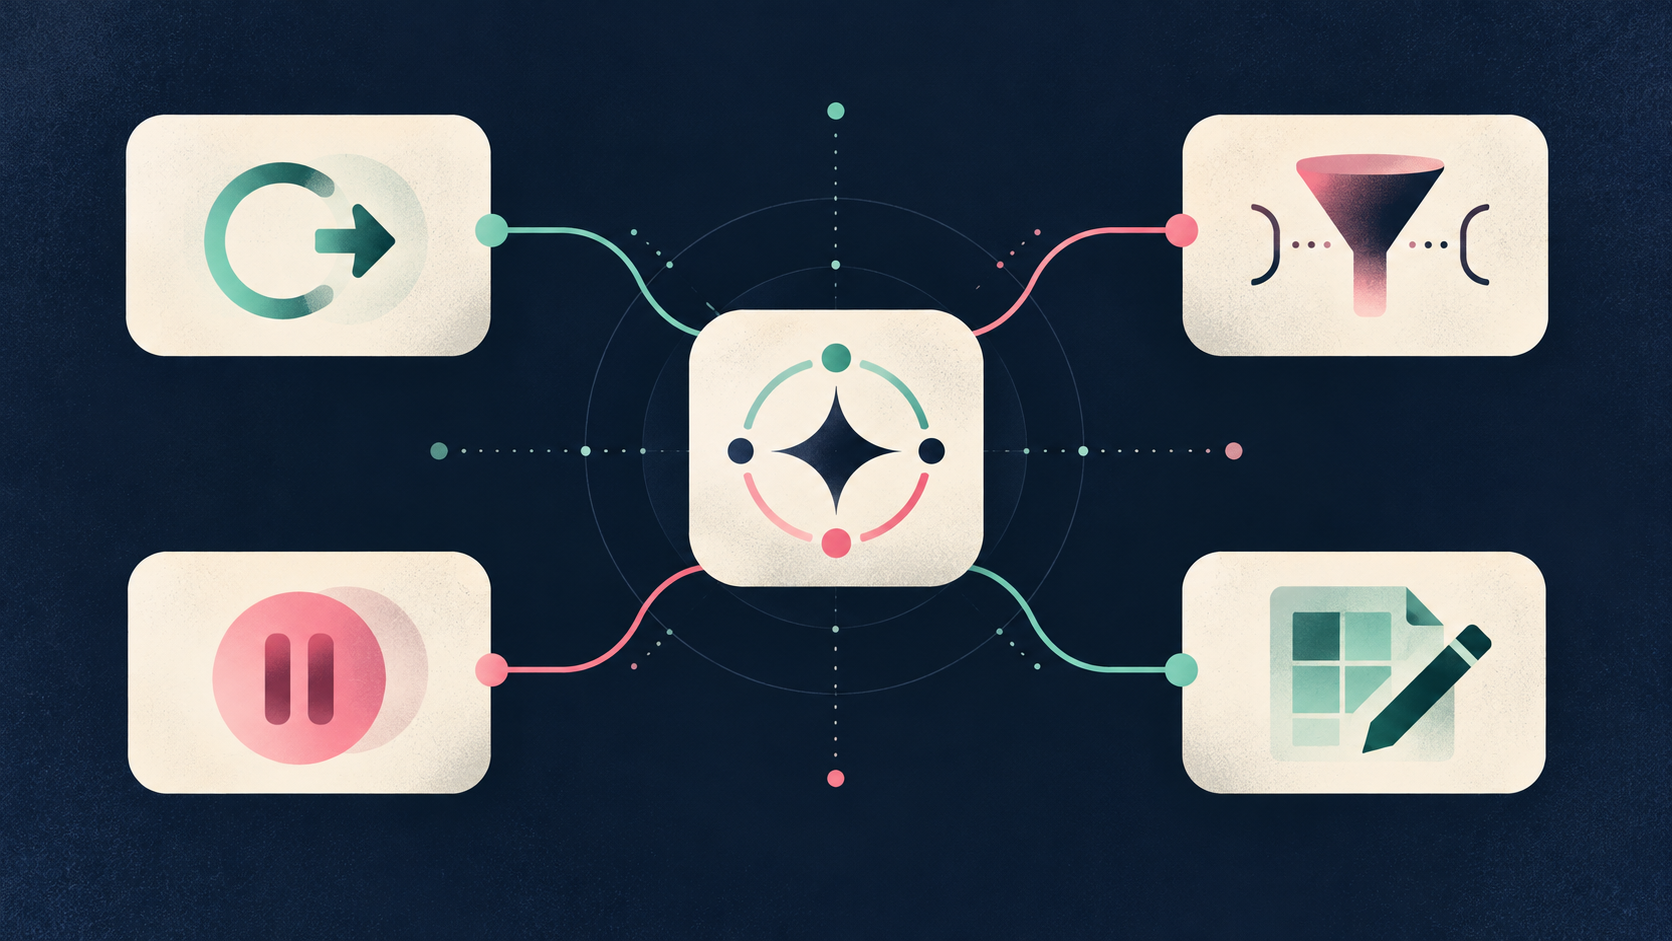
유지·축소·중단·수정은 이렇게 갈립니다
| 질문 유형 | 관측값 | 품질 신호 | 다음 결정 |
|---|---|---|---|
| 반복 보고 | 비용·지연을 확인할 수 있음 | 검증 수정이 줄어듦 | 유지: 담당자와 검토 주기를 명시합니다. |
| 범위가 넓은 탐색 | 비용이 불명확하거나 변동이 큼 | 재질문이 잦음 | 축소: 데이터 경로와 질문 범위를 좁힙니다. |
| 반복 위임 | 예산·지연 상한을 반복 초과 | 사람 수정이 줄지 않음 | 중단: 수동 절차 또는 다른 설계로 되돌립니다. |
| 정형 질문 | 실행은 가능하나 근거가 불완전 | 같은 오해가 반복됨 | 질문 템플릿 수정: 기간·지표·출력 형식을 고정합니다. |
이 표의 핵심은 임의의 기준값을 정하는 데 있지 않습니다. 팀이 감당할 수 있는 예산·지연·검토 부담의 상한을 먼저 합의하고, 원장이 그 상한을 넘는 패턴을 보여 주도록 만드는 데 있습니다.
예시: ‘지난주 매출 하락 이유’를 기록하는 방법
아래는 실제 고객 사례나 실측치가 아닌 기록 형식 예시입니다. “지난주 매출 하락 이유”라는 요청이 들어오면 질문 유형을 ‘주간 반복 분석’으로 두고, 실행 식별자와 요청 시각을 남깁니다. 관측 가능한 처리량이나 지연이 있다면 적고, 질문 단위로 연결할 수 없다면 unknown으로 남깁니다.
답변에서 기간 비교 기준이 빠져 사람이 다시 물었다면 재질문 1회로 기록합니다. 검토자가 특정 채널의 집계 조건을 고쳤다면 ‘해석 수정’으로 남깁니다. 이런 일이 반복됐다면 모델을 바꾸기 전에 질문 템플릿에 비교 기간, 지표 정의, 제외 조건, 근거 표기 방식을 넣어야 합니다.
도입 체크리스트: 가장 작은 시범 운영부터
- 질문 유형과 실행 식별자를 연결할 수 있나요?
- 관측된 값과 unknown 값을 구분해 남기나요?
- 실패·재시도·사람 수정이 누락되지 않나요?
- 유지·축소·중단의 상한과 결정 담당자가 정해져 있나요?
- 읽기 전용의 좁은 질문으로 시작해 결과를 다시 검토하나요?
처음부터 모든 데이터를 맡기기보다, 매주 반복되며 검토 기준이 비교적 분명한 질문 하나를 고르세요. 이후 답변 근거 패킷으로 근거를 확인하고, 검증된 질의 표면 계약으로 허용 경로를 정하면 운영 기록의 의미가 더 또렷해집니다.
자주 묻는 질문
비용을 질문 단위로 정확히 나눌 수 없다면 시작하면 안 되나요?
그렇지 않습니다. 알 수 없는 값을 추정치로 꾸미지 말고 unknown으로 남기세요. 무엇을 관측할 수 없는지 확인한 뒤, 기록 범위를 좁히거나 추적 방식을 보완하는 편이 낫습니다.
정확한 답변이면 사람 검토를 없애도 될까요?
반복 질문에서 수정이 충분히 줄었다는 기록이 쌓이기 전에는 검토를 유지하는 편이 좋습니다. 기간·지표 정의·권한 경계가 걸린 질문은 검토 기준을 명시하세요.
실패가 한 번 나왔다고 바로 중단해야 하나요?
한 번의 실패보다 패턴이 중요합니다. 실패 이유, 재시도 결과, 영향 범위를 함께 보고 질문 템플릿 수정이나 범위 축소가 먼저인지 판단하세요.
원장은 누가 관리하는 것이 좋나요?
질문을 실제로 사용하는 업무 담당자와 데이터 검토 책임자가 함께 봐야 합니다. 한 사람의 기억에 의존하지 말고 다음 결정을 확인할 수 있는 공유 기록으로 유지하세요.
참고 자료
- Google Cloud 공식 블로그: Agentic Data Cloud의 새 데이터 에이전트 — 자연어 데이터 인사이트와 에이전트 기반 작업 흐름이 논의되는 배경을 확인할 수 있습니다.
- Google Cloud 문서: Conversational analytics 개요 — 검증된 질의와 에이전트 맥락·지침의 개념을 확인할 수 있습니다.
- Google Cloud 문서: 데이터 에이전트 만들기 — 구성과 운영 시 살펴볼 공식 문서입니다.
- Google Cloud 문서: 상세 사용량 내보내기 구조 — 자원 수준 사용량 정보의 범위와 한계를 확인할 수 있습니다.
이 글이 마음에 드세요?
FLOWIT on YouTube
영상으로도 FLOWIT을 이어서 보세요
AI 자동화, Claude Code, n8n, 데이터 분석 흐름을 블로그와 영상으로 함께 정리하고 있습니다.
Related Notes
같이 읽으면 좋은 FLOWIT 글
 AI 에이전트 정책, 차단률만 보면 될까? 오차단·우회까지 보는 5지표 운영표AI 에이전트 정책의 성공을 차단 수만으로 판단하지 마세요. 오차단, 우회, 도구 호출 변화, 완료율을 정책 버전별로 확인해 유지·조정·되돌리기를 결정하는 5지표 운영표를 정리합니다.
 프롬프트 캐시가 싸졌다고 그대로 고정해도 될까? 6칸 컨텍스트 릴리스 카드AI 에이전트 프롬프트 캐시를 운영할 때 비용만 보지 않고, 컨텍스트 경계와 변경 무효화 기준, hit/miss 품질 비교, 되돌리기 책임까지 6칸 릴리스 카드로 점검하는 실무…
 AI 에이전트 Tool Search, 켜기 전에 확인하세요: 6칸 발견 품질 카드도구 검색은 단순히 도구를 덜 보여 주는 설정이 아닙니다. 10개 대표 업무로 필요한 도구의 발견, 불필요한 고권한 도구 노출, 지연·입력 토큰·fallback을 함께 확인하는 배포…