읽는 시간 약 9분 · AI 에이전트 운영 가이드
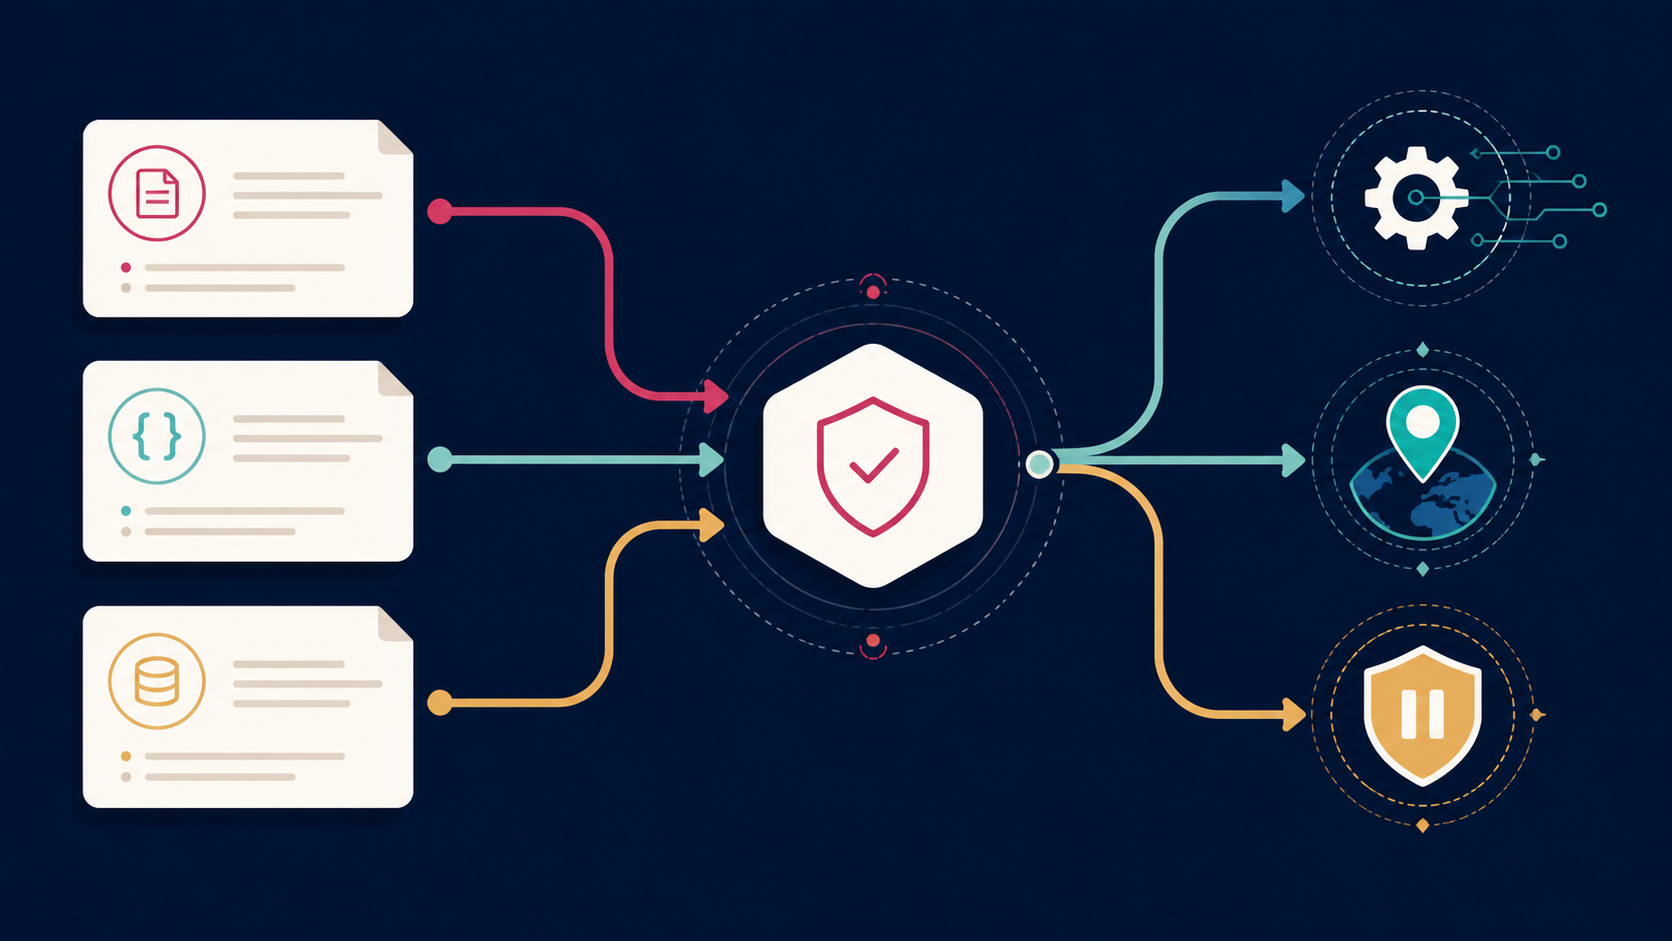
먼저 답하면: 공개 문서, 고객 식별정보가 섞인 문의, 제한 분석 결과를 같은 AI API 경로로 보내면 안 될 수 있습니다. 요청을 보내기 직전에 데이터 등급·허용 처리 지역·모델 적격성·승인 상태를 확인하고, 통과하지 못하면 일반 경로로 조용히 넘기지 않는 운영 계약이 필요합니다.
이 글에서는 팀이 바로 검토할 수 있도록 데이터 등급별 경로 매트릭스, 요청 전 정책 검사, 장애 런북, 감사 기록 항목을 정리합니다. 특정 제품 설정값을 그대로 복사하기보다, 도입 전 어떤 결정을 문서화해야 하는지에 초점을 맞춥니다.
핵심 요약
- 지역 처리 선택은 모든 요청에 같은 보장을 붙이는 기능이 아니라, 지원 조건 아래 요청별로 처리 경로를 고르는 제어입니다.
- 분류가 비어 있거나 허용 지역·모델·승인 조건이 맞지 않으면, 기본값은 중단 또는 보류가 안전합니다.
- 입력 문장뿐 아니라 파일, 도구 반환값, 외부 시스템으로 넘기는 데이터도 다시 분류해야 합니다.
- 비용, 권한, 신뢰성은 한 장의 정책으로 연결됩니다. 선택한 경로와 이유를 남기지 않으면 사고 뒤에 재현하기 어렵습니다.
왜 같은 에이전트에 경로가 여러 개 필요한가
에이전트가 회의록을 요약하고 고객 문의를 분류하며 내부 분석 결과까지 설명한다면, 겉보기에는 모두 “텍스트 요청”입니다. 그러나 요청 안에 들어 있는 정보와 실패했을 때의 피해는 같지 않습니다. 공개 릴리스 노트는 비교적 단순한 검토 경로로 보낼 수 있지만, 고객 식별정보·계약상 제한된 자료·도구가 돌려준 원본 데이터는 별도 판단이 필요합니다.
여기서 중요한 질문은 “어느 지역이 더 좋을까?”가 아닙니다. 이 요청이 어떤 조건에서 어느 처리 경로를 사용할 수 있고, 조건이 깨지면 누가 무엇을 결정할 것인가?입니다. 이 답을 코드 밖의 구두 관행에 맡기면, 새 도구나 새 모델이 붙을 때마다 예외가 늘어납니다.
공식 문서로 확인할 수 있는 범위와 한계
OpenAI의 변경 이력은 Global geography 프로젝트에서 API 키와 접두 도메인을 사용해 개별 요청의 regional processing을 선택할 수 있다고 설명합니다. 다만 기존의 적격성, 데이터 보존, endpoint와 모델 지원 조건은 계속 적용됩니다. 즉 요청별 선택이 가능하다는 사실은, 모든 요청·모든 모델이 어느 지역에서나 처리된다는 뜻은 아닙니다.
데이터 제어 안내도 프로젝트 구성과 요청별 선택을 구분합니다. 지역별로 storage와 processing 지원 범위가 다를 수 있고, system data 및 특정 조건은 선택한 지역 밖에서 처리·저장될 수 있다고 명시합니다. 따라서 “지역 처리를 켰으니 모든 계약과 규제를 충족했다”는 결론으로 넘어가면 안 됩니다.
비용도 배포 판단의 일부입니다. 가격 문서는 2026년 3월 5일 이후 출시된 data-residency 적격 모델의 regional processing endpoint에 10% uplift가 적용된다고 안내합니다. 적용 모델과 가격은 바뀔 수 있으므로, 배포 직전에 해당 프로젝트·모델·endpoint의 공식 표를 다시 확인해야 합니다.
데이터 등급×처리 경로를 먼저 합의하세요
아래 표는 제품별 정답이 아니라 팀의 정책 초안입니다. 데이터가 어떤 경로를 타는지보다 먼저, 무엇을 넣는지와 누가 예외를 승인하는지를 적어 두는 것이 핵심입니다.
| 등급 | 예시 입력·반환값 | 허용 경로 | 사전 조건 | 실패 시 | 남길 기록 |
|---|---|---|---|---|---|
| 공개 | 공개 문서 요약, 공개 FAQ | 일반 또는 지역 처리 | 출처·목적 확인 | 재시도 큐 | 정책 버전, 모델, 목적 |
| 내부 | 비공개 운영 문서, 미공개 계획 | 승인된 프로젝트·경로만 | 최소 입력, 접근 승인 | 보류 후 담당자 확인 | 승인 ID, 데이터 원천 |
| 개인정보 포함 | 이름·연락처가 섞인 문의, 도구 반환값 | 정책상 허용된 지역 처리 또는 비식별화 후 재평가 | 분류·보존·계약 확인 | 일반 경로로 전환하지 않음 | 비식별화 여부, 선택 지역 |
| 제한 | 계약상 제한 자료, 민감 분석 결과 | 사전 승인된 전용 경로 또는 호출 차단 | 승인 유효성, 모델·endpoint 적격성 | 차단·사람 승인 | 차단 사유, 승인자, 사건 ID |
표는 작은 화면에서 좌우로 밀어 전체 열을 확인하세요.
예를 들어 고객 문의를 요약하는 에이전트가 CRM 도구에서 연락처와 상담 이력을 함께 받았다면, 처음 프롬프트에 연락처를 쓰지 않았더라도 도구 반환값이 등급을 바꿉니다. 도구 호출 뒤에 한 번 더 분류하지 않으면, 설계 당시에는 없던 데이터가 일반 경로로 섞일 수 있습니다.
요청 전 라우팅 계약 5단계
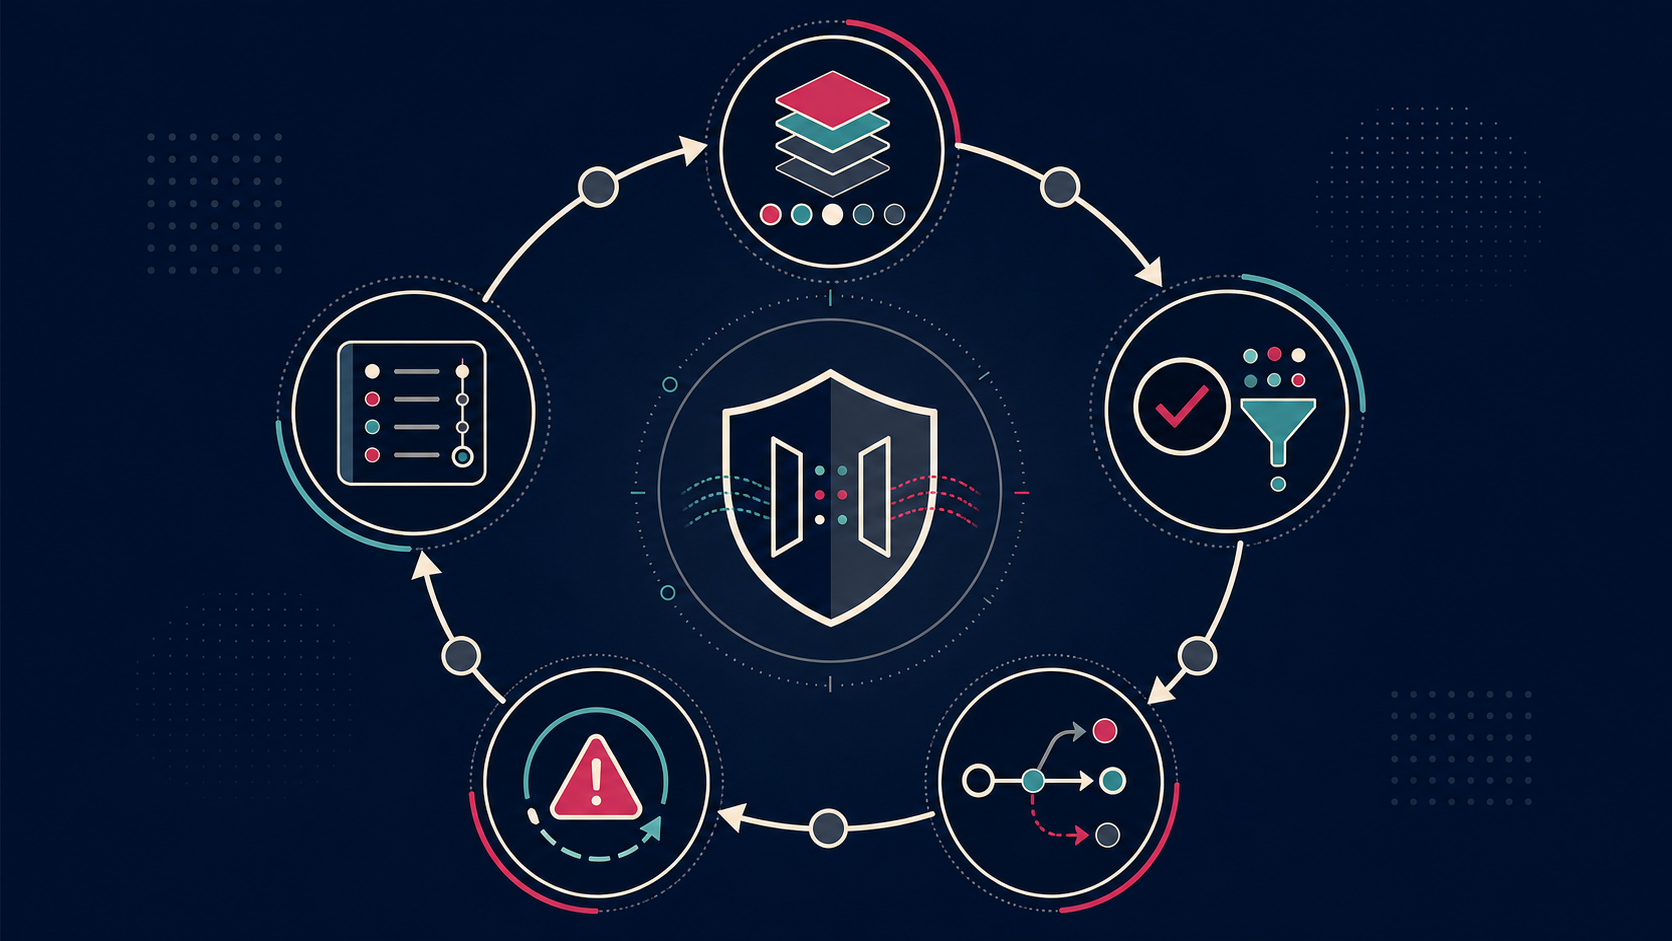
- 1. 분류합니다. 프롬프트, 첨부 파일, tool 반환값, 외부 시스템 전송값을 함께 보고 등급과 목적을 붙입니다.
- 2. 적격성을 확인합니다. 프로젝트, 선택 지역, endpoint, 모델, 보존 조건, 승인 유효기간이 해당 등급에 맞는지 검사합니다.
- 3. 경로를 고릅니다. 통과한 요청에만 일반 처리 또는 지역 처리 경로를 선택합니다. 비용 태그도 이때 붙여 예산 변화를 추적합니다.
- 4. 실패를 닫힌 방식으로 다룹니다. 분류 누락·미지원 모델·승인 만료·지역 오류에서는 호출을 멈추고, 보류·비식별화 재시도·사람 승인 중 정책상 허용된 조치만 합니다.
- 5. 결정을 기록합니다. 나중에 “왜 이 요청이 이 경로로 갔는가”를 재현할 수 있도록 정책 버전과 근거를 남깁니다.
decision = evaluate(request)
if decision.classification is None:
    hold("classification_missing")
elif not eligible(decision.region, decision.model, decision.project):
    hold("route_not_eligible")
elif decision.approval_expired:
    hold("approval_expired")
else:
    send(decision.endpoint)
    audit(decision)
위 의사코드의 핵심은 특정 언어가 아닙니다. 호출을 먼저 하고 사후에 설명하는 방식이 아니라, 정책이 통과해야 호출이 가능하도록 순서를 고정하는 데 있습니다.
감사 기록은 결과 로그보다 넓어야 합니다
응답 텍스트만 남기면, 문제가 났을 때 어떤 규칙이 적용되었는지 알기 어렵습니다. 최소한 request_class, policy_version, purpose, selected_region, project, model, tool_data_source, approval_id, fallback_attempted, cost_tag, decision_reason을 구조화해 남기는 편이 좋습니다.
지역 endpoint가 실패했을 때 무엇을 멈출 것인가
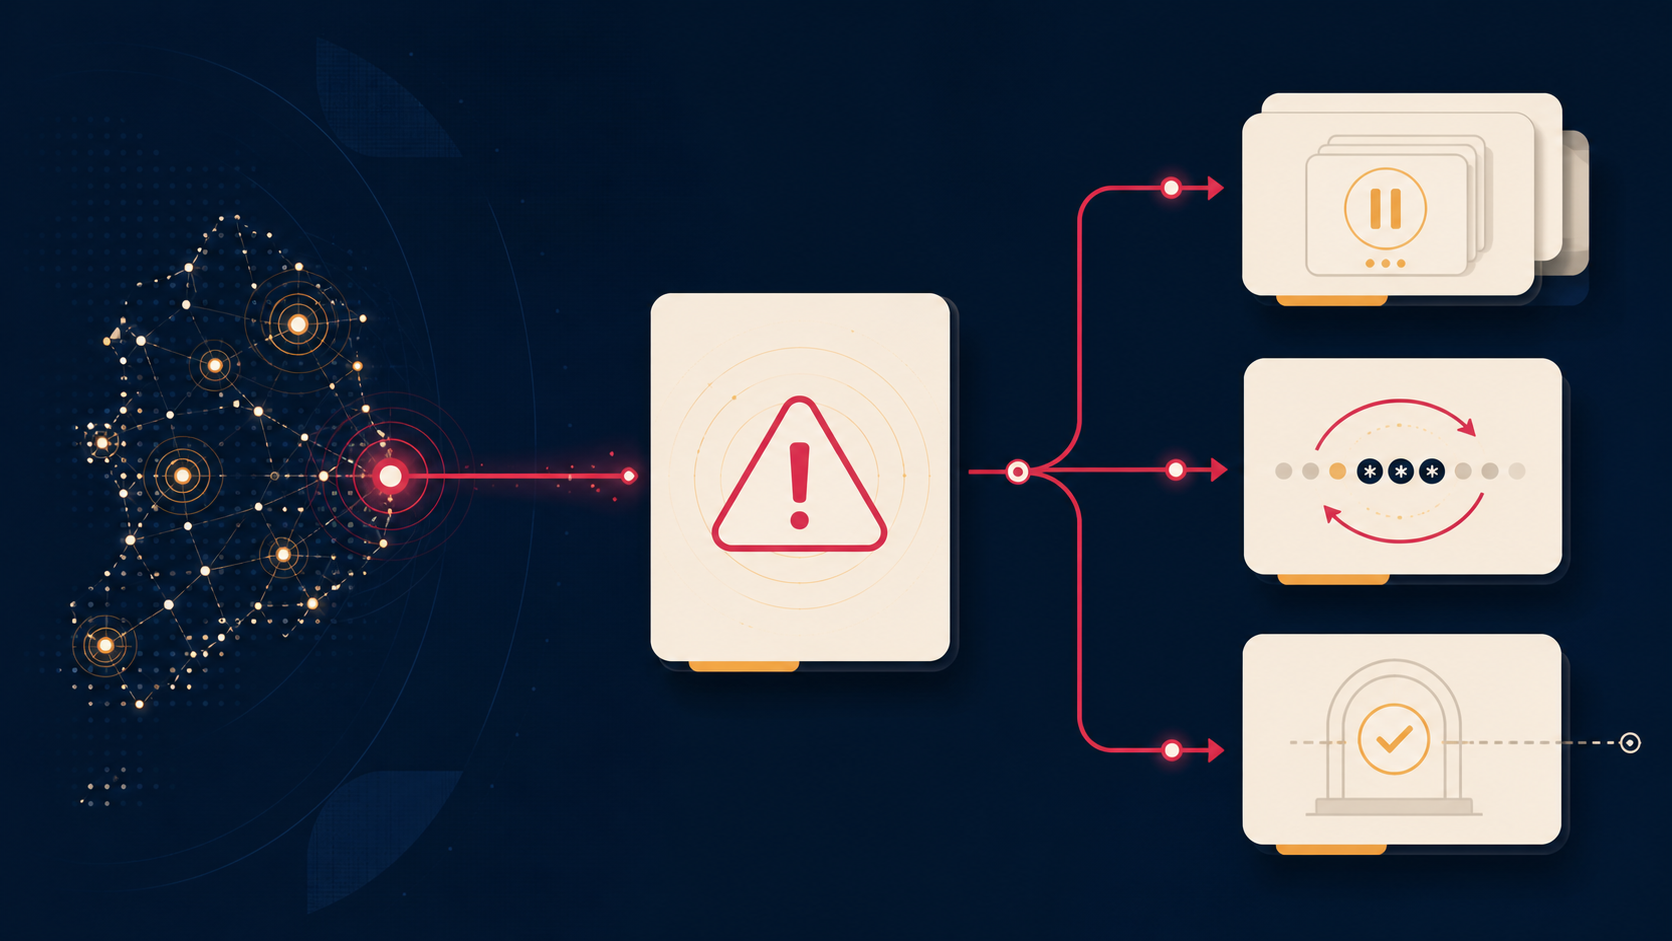
운영에서 가장 위험한 기본값은 “지역 경로가 실패했으니 일반 경로로 한 번 더 보내자”입니다. 이 재시도는 성공률을 높여 보일 수 있지만, 처음 경로를 선택한 이유를 무력화할 수 있습니다. 특히 제한 등급이나 개인정보 포함 요청에서는 자동 전환이 허용되는지부터 정책에 적어야 합니다.
| 상황 | 하지 않을 일 | 우선 조치 | 재개 조건 |
|---|---|---|---|
| 지역 endpoint 오류 | 승인 없이 일반 경로 재전송 | 요청 보류, 오류 코드 기록 | 경로 복구 또는 승인된 대체 경로 확인 |
| 모델·endpoint 미지원 | 다른 모델로 임의 변경 | 호환 조합 확인, 담당자에게 전달 | 정책에 등록된 조합과 승인 확인 |
| 분류 누락 | 낮은 등급으로 추정 | 입력·도구 반환값 재분류 | 등급과 목적이 확정됨 |
| 개인정보 포함 요청 | 원문 그대로 우회 전송 | 비식별화 가능성 검토 또는 사람 승인 | 변환 결과 재분류 또는 명시적 승인 |
비식별화 재시도도 자동 만능키가 아닙니다. 원문과 결합하면 다시 식별될 수 있는 값, 도구의 숨은 메타데이터, 첨부 파일의 내용까지 범위에 들어갈 수 있습니다. 따라서 변환 뒤에도 같은 정책 검사를 다시 통과시키는 것이 좋습니다.
배포 전 12문항 점검표
- 요청마다 데이터 등급과 처리 목적을 붙일 수 있나요?
- 프롬프트 외에 첨부 파일과 tool 반환값도 재분류하나요?
- 등급별 허용 프로젝트·지역·endpoint·모델 조합이 문서화되어 있나요?
- 지원표와 계약 조건을 배포 직전에 확인하는 담당자가 있나요?
- 분류 누락·승인 만료·미지원 조합에서 호출이 차단되나요?
- 일반 경로로의 자동 전환이 허용되는 등급과 금지되는 등급이 분명한가요?
- 예외 승인의 범위와 만료 시점이 기록되나요?
- 선택 지역·모델·endpoint와 판단 이유를 감사 기록에 남기나요?
- 로그를 읽을 수 있는 사람과 보존 기간이 정해져 있나요?
- 가격 변경 또는 uplift를 비용 태그와 예산 검토에 연결했나요?
- 지역 경로 장애 시 보류·재시도·사람 승인 역할이 정해져 있나요?
- 새 도구·새 파일 유형·새 모델을 붙일 때 정책 검사를 다시 실행하나요?
자주 묻는 질문
지역 처리를 선택하면 규제와 계약 검토가 끝나나요?
아닙니다. 공식 문서의 지원 범위, 프로젝트 구성, 보존 조건, system data 처리, 조직의 계약과 내부 규칙을 함께 확인해야 합니다. 지역 선택은 검토해야 할 항목 중 하나입니다.
지역 endpoint가 실패하면 일반 endpoint로 자동 재시도해도 되나요?
데이터 등급과 사전 승인에 따라 다릅니다. 제한 자료나 개인정보 포함 요청처럼 처음부터 별도 경로를 택한 이유가 있는 경우에는, 자동 전환보다 보류·비식별화 재검사·사람 승인이 안전한 기본값입니다.
데이터 분류는 프롬프트 본문만 보면 되나요?
아닙니다. 첨부 파일, tool 반환값, 외부 시스템으로 전송되는 값도 요청의 위험을 바꿀 수 있습니다. 도구 호출 뒤에 다시 검사하는 단계를 두세요.
10% uplift는 모든 요청에 적용되나요?
그렇게 일반화하면 안 됩니다. OpenAI 가격 문서는 2026년 3월 5일 이후 출시된 data-residency 적격 모델의 regional processing endpoint에 적용된다고 안내합니다. 실제 대상과 가격은 배포 직전 공식 가격표를 확인하세요.
정책 엔진을 만들기 전 가장 먼저 할 일은 무엇인가요?
세 가지 데이터 등급과 각 등급의 기본 실패 조치를 합의하세요. 분류가 없으면 보류한다는 한 줄의 규칙만으로도, 조용한 우회를 줄이고 이후 구현의 기준점을 만들 수 있습니다.
참고 자료
- OpenAI API Changelog — 2026년 8월 21일 변경 이력에서 요청별 regional processing 선택과 적용 조건을 확인했습니다.
- OpenAI Platform Data Controls — 프로젝트 구성, 요청별 처리 지역, 지역별 storage·processing 지원 및 한계를 확인했습니다.
- OpenAI API Pricing — data-residency 적격 모델의 regional processing endpoint 비용 조건을 확인했습니다.
공식 문서와 가격표는 변경될 수 있습니다. 실제 도입 전에는 사용하는 프로젝트·모델·endpoint와 조직의 계약 조건을 다시 확인하세요.
이 글이 마음에 드세요?
FLOWIT on YouTube
영상으로도 FLOWIT을 이어서 보세요
AI 자동화, Claude Code, n8n, 데이터 분석 흐름을 블로그와 영상으로 함께 정리하고 있습니다.
Related Notes
같이 읽으면 좋은 FLOWIT 글
 AI 코딩 에이전트, 벤치마크 1위면 도입해도 될까? 우리 저장소에서 먼저 돌릴 10개 업무 실험 카드AI 코딩 에이전트의 외부 점수와 데모만으로 결정하지 마세요. 대표 업무 10개와 5개 관측칸으로 1주 파일럿을 설계하는 방법을 정리합니다.
 AI 에이전트 승인창이 많을수록 안전할까? 장기 작업의 승인 피로를 막는 5칸 개입 예산장기 실행 AI 에이전트에서 승인 알림만 반복하지 않도록, 비가역성·계획 이탈·새 권한을 기준으로 재승인 지점과 증거 묶음을 설계하는 5칸 개입 예산을 정리합니다.
 AI 에이전트가 503 때 싼 모델로 바뀌어도 될까? fallback 품질을 같게 만드는 5개 테스트주 모델 장애나 과부하로 fallback 모델로 전환되어도 답변 품질을 유지하는 공통 validator 설계와 5개 실패 주입 테스트를 운영 카드로 정리했습니다.