읽는 시간 약 8분
짧은 답: 공유 Fabric capacity에서 Project Osmos 작업을 시작할 때는 언어 모델 사용량만 보지 말고, Spark 실행·검증 사용량과 공유 lakehouse의 귀속 한계, 동시 작업과 throttling을 함께 확인하셔야 합니다.
이 글에서는 대표 작업을 어떻게 제한하고 어떤 증거를 기록해야 ‘작업 시작·제한 파일럿·보류’를 고를 수 있는지 6칸 판단 카드로 정리합니다.
핵심 요약
- Project Osmos 작업의 자원 사용은 언어 모델과 Spark 두 경로로 나뉩니다. 토큰만으로 전체 작업량이나 총비용을 대표할 수 없습니다.
- 공유 lakehouse의 Spark 합계에는 다른 작업·사용자의 활동이 섞일 수 있고, 사용량이 지표에 나타나기까지 시간이 걸릴 수 있습니다.
- 대표 데이터의 bounded 작업에서 두 소비 성분을 각각 살펴본 뒤, capacity 관리자와 utilization·throttling 및 동시성 조건을 확인하는 편이 안전합니다.
- Project Osmos는 현재 preview입니다. 아래의 ‘시작’과 ‘제한 파일럿’은 preview 범위 안의 평가를 뜻하며, production 사용 승인을 뜻하지 않습니다.
왜 토큰 하나로 판단하면 안 될까요?
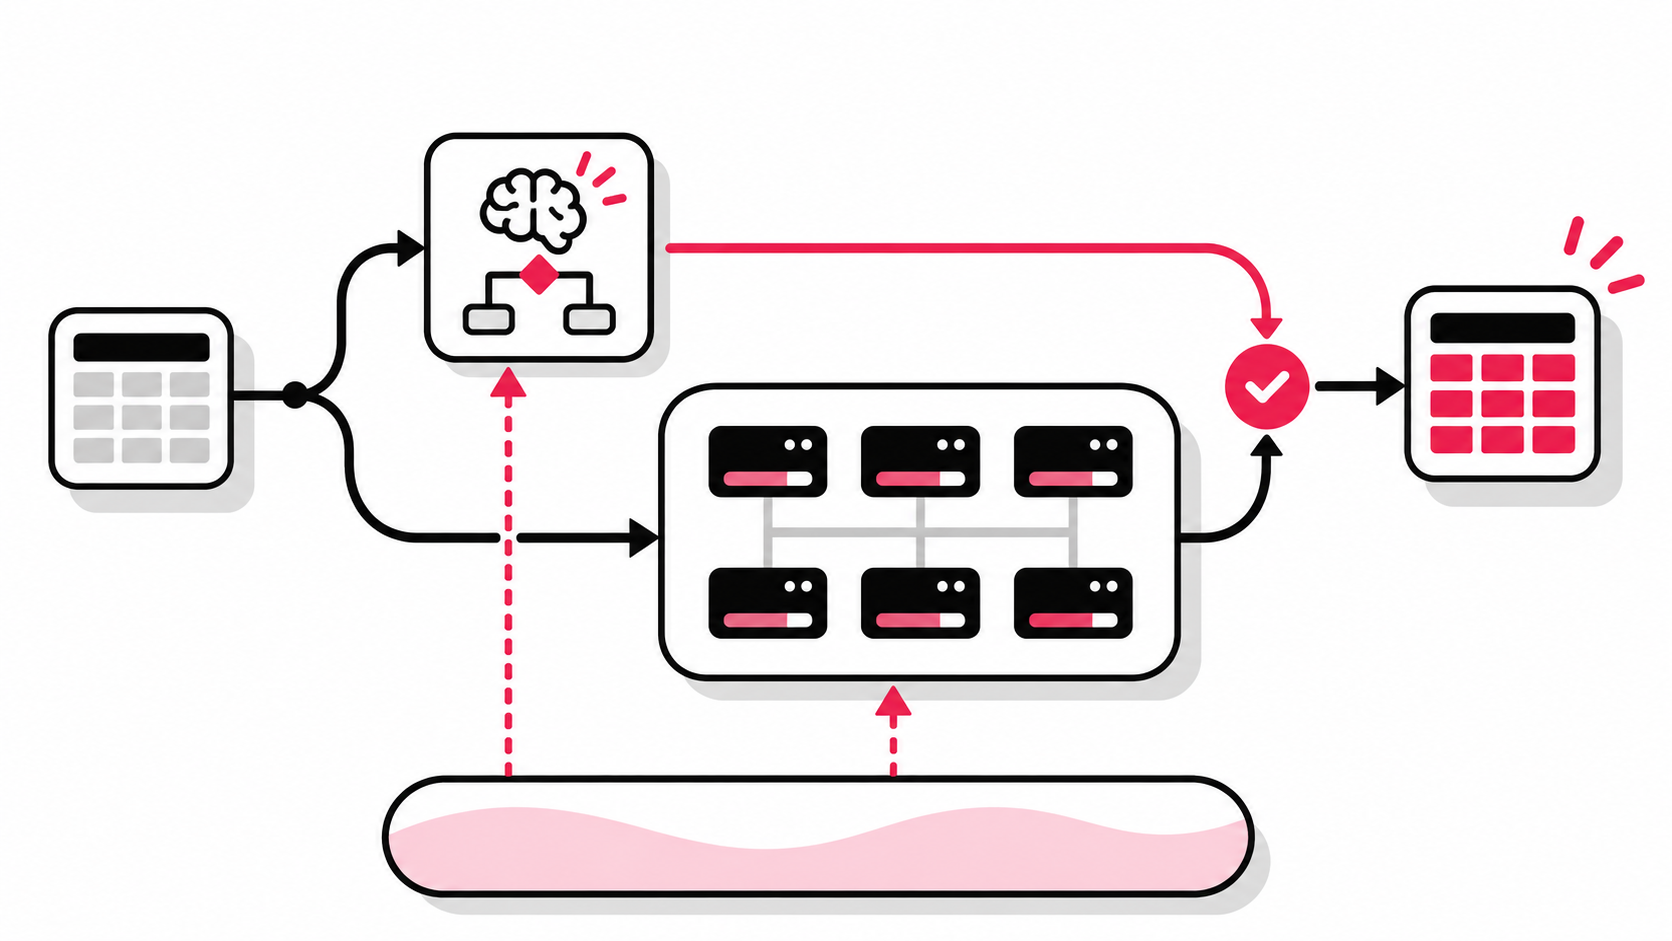
Project Osmos는 자연어로 지시를 받는 데서 끝나지 않습니다. 작업을 계획하고 코드를 만들 때는 언어 모델을 사용하고, 생성한 Spark 코드를 실행하거나 구현 방법을 시험하고 결과를 검증할 때는 Spark compute를 사용합니다. Microsoft의 Project Osmos 소비량 안내도 두 성분을 함께 보라고 설명합니다.
그래서 토큰 수가 낮아 보여도 데이터 변환·조인·집계가 크거나 구현 시도와 검증 실행이 반복되면 Spark 작업이 늘 수 있습니다. 반대로 비슷한 입력 문장이라도 데이터량과 변환 방식이 다르면 소비 양상은 달라질 수 있습니다. 문서가 설명하는 것은 측정해야 할 구성요소이지, 모든 tenant에 적용되는 고정 비용표가 아닙니다.
실무 기준: “에이전트 비용”이라는 단일 숫자를 먼저 만들기보다, 언어 모델 operation과 Spark 작업을 각각 관찰할 수 있는지부터 확인하세요.
Project Osmos 작업의 범위와 주의점
Project Osmos는 Microsoft Fabric 리소스에서 데이터 엔지니어링 작업을 계획·실행·검증하는 persistent task 기능입니다. 공식 개요에 따르면 데이터 탐색, Spark notebook 작성과 시험, 변환, Delta table 쓰기와 결과 검증을 수행할 수 있고, 로컬 클라이언트 연결이 끊긴 뒤에도 Fabric에서 task가 계속될 수 있습니다. 작업 범위는 Project outcome, Fabric 권한, 검토한 실행 설정에 따라 정해집니다. 자세한 경계는 Microsoft Learn의 공식 개요에서 확인할 수 있습니다.
중요한 운영 경계가 있습니다. Microsoft 문서는 Project Osmos를 preview로 표시하며 production 용도로 의도되지 않고 SLA가 없으며 일부 지역에서만 제공될 수 있다고 안내합니다. 따라서 여기서 제안하는 시작 카드는 production 전환 승인표가 아니라, preview 기능을 제한된 범위에서 검토할 때 사용할 측정·중단 기록입니다.
언어 모델과 Spark를 따로 살펴보세요
Capacity Metrics에서 Project Osmos operation과 Spark 사용량을 분리해 확인해야 합니다. 언어 모델 쪽은 계획·추론·코드 생성에 쓰인 입력·출력 token과 관련되고, Spark 쪽은 코드 실행, 구현 실험, 데이터 처리, 검증 실행과 관련됩니다. 구현 시도나 검증이 반복되면 두 성분 모두 늘어날 수 있습니다.
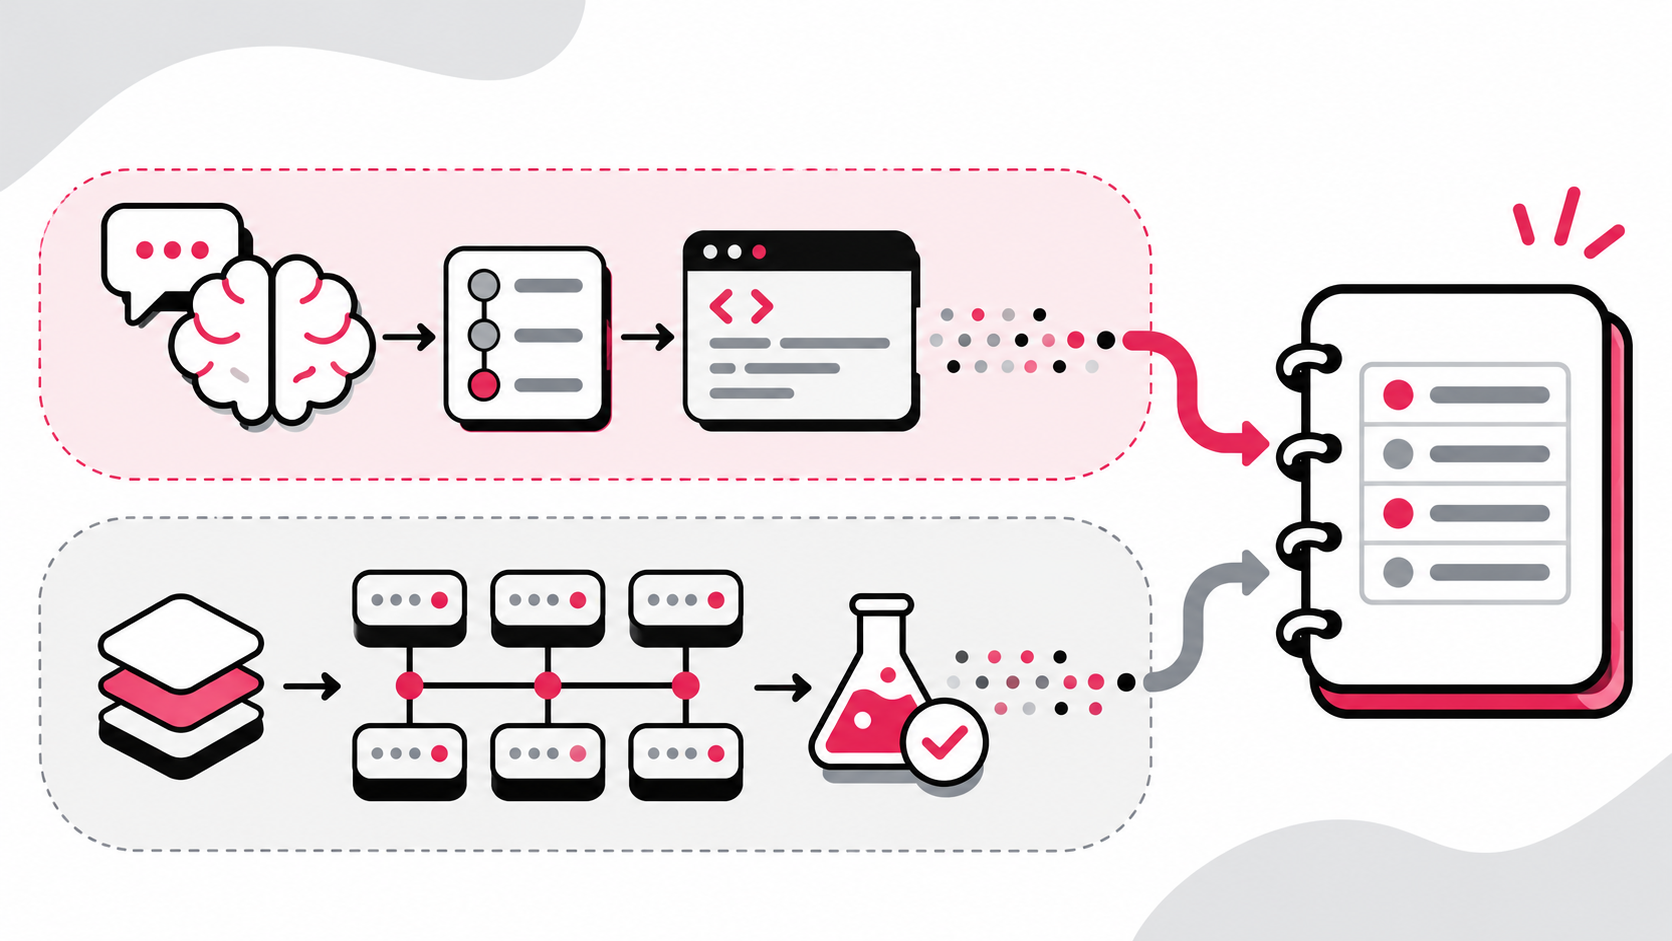
언어 모델 사용량은 Project Osmos operation으로, Spark 사용량은 Spark 소비 경로로 살펴보라는 것이 공식 문서의 구분입니다. 다만 실제 표시 위치와 반영 시간은 선택한 Capacity Metrics 보고서와 환경의 설정을 확인해야 합니다. 측정 구간, task 식별자, 관찰 시각을 함께 남기면 나중에 서로 다른 실행을 섞어 비교하는 일을 줄일 수 있습니다.
질문별 자연어 데이터 분석 비용을 정리하는 방식이 필요하다면 FLOWIT의 AI 데이터 에이전트 질문별 실행 원장도 참고할 수 있습니다. 다만 그 글의 단위는 질문별 실패·재시도·사람 수정 기록이고, 이 글의 초점은 Project Osmos task의 Spark와 공유 capacity 측정입니다.
공유 lakehouse에서는 어디까지 귀속할 수 있을까요?
Capacity Metrics에 나타난 lakehouse의 Spark 합계를 한 Project Osmos task의 사용량으로 곧바로 간주하면 안 됩니다. 공식 소비량 문서는 같은 lakehouse를 쓰는 다른 task와 사용자의 활동이 합계에 포함될 수 있고, 사용량이 보고서에 표시되기까지 지연될 수 있다고 명시합니다.
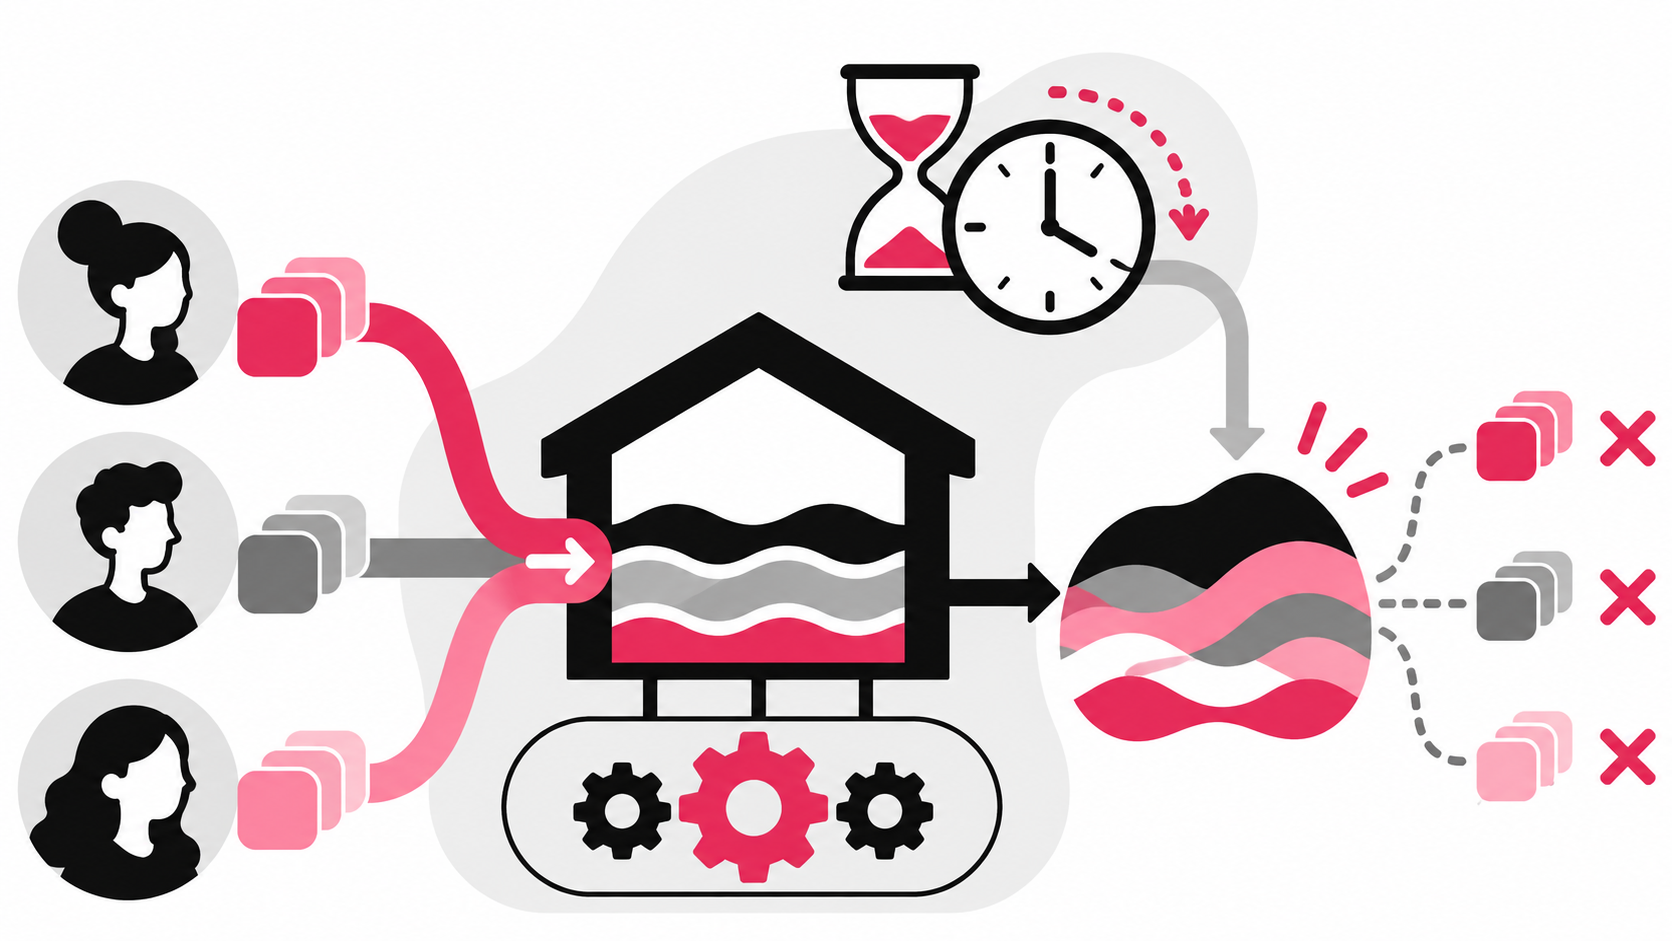
이 경우 기록할 값은 억지로 나눈 추정치가 아닙니다. “관측된 공유 합계”, “동시간대에 함께 실행된 task”, “보고서 확인 시각”, “단일 task 귀속 가능 여부”를 분리해 남기세요. task별 분리가 확인되지 않으면 귀속 불가 또는 미확인으로 표시하는 편이 근거 없는 정밀도를 만드는 것보다 낫습니다.
또한 같은 capacity에 별도 workspace를 만들었다고 해서 compute가 격리되는 것은 아닙니다. Microsoft의 공유 capacity 모범 사례는 제출 시점을 분산하고 동시에 실행하는 task 수를 제한하며, capacity 관리자에게 utilization과 throttling 검토를 요청하라고 안내합니다.
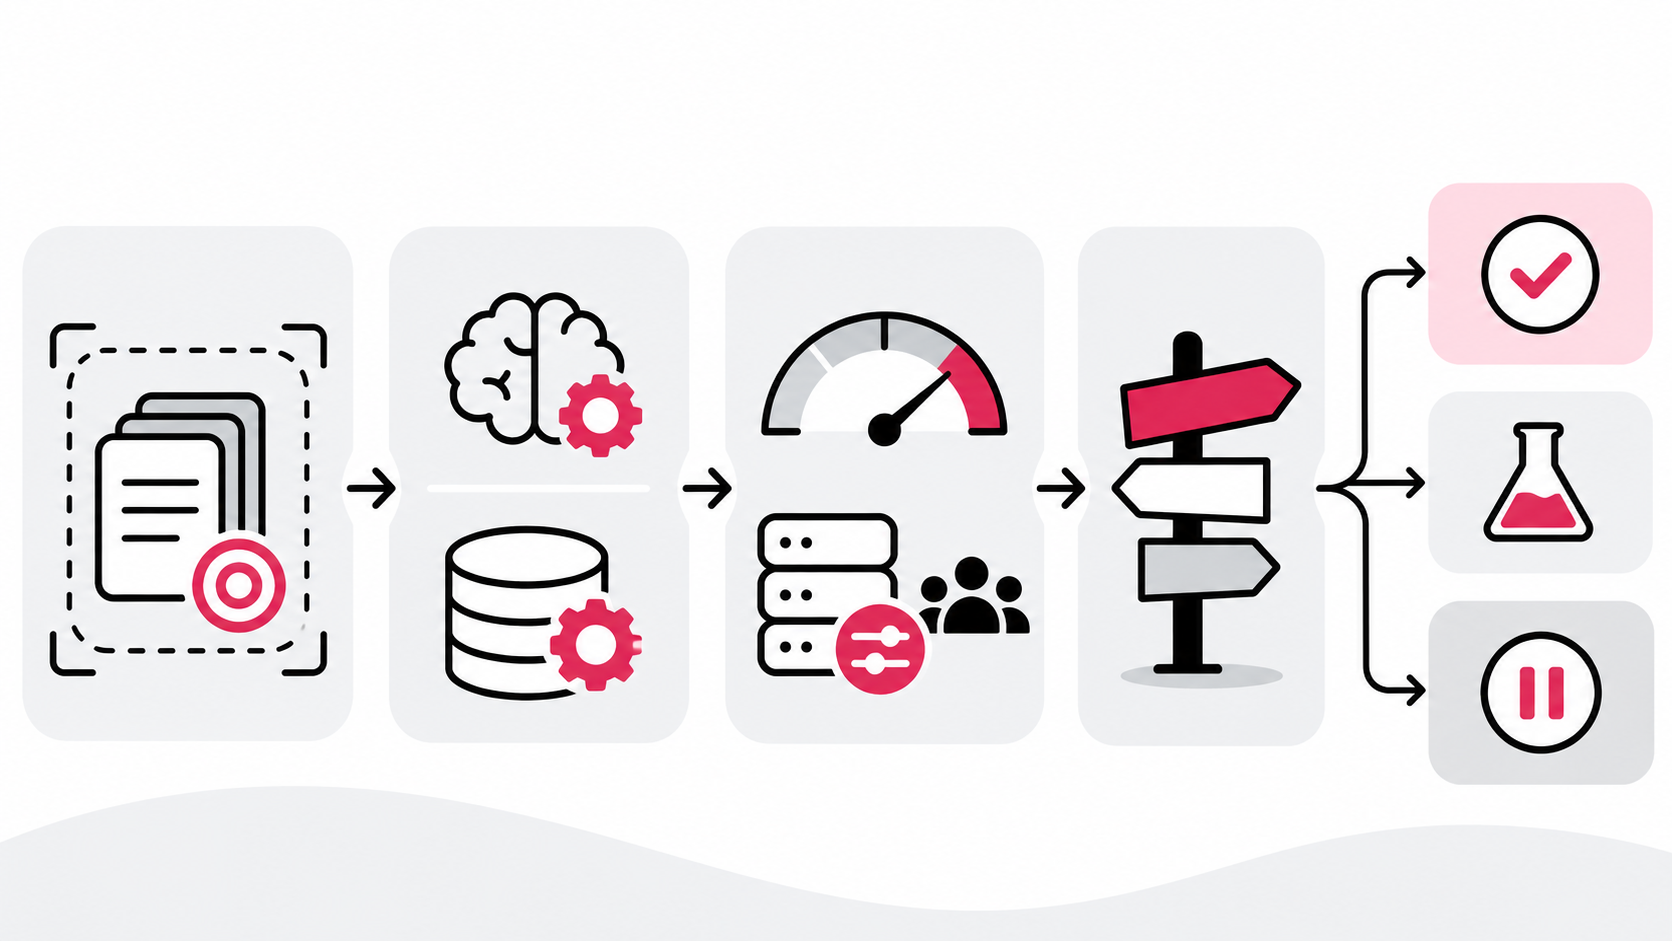
6칸 shared-capacity 시작 카드
아래 카드는 공식 문서의 측정 항목과 제한을 실제 운영 기록으로 바꾼 FLOWIT의 제안입니다. 숫자 기준이나 자동화된 승인 규칙이 아닙니다. 먼저 각 칸에 관측 가능한 값과 담당자를 적고, 확인되지 않은 값은 빈칸 대신 “미측정” 또는 “귀속 불가”로 남기세요.
- 작업 경계: 완료할 결과, 사용할 source, 허용된 읽기·쓰기 대상, 보존해야 할 기존 artifact, 성공 검증 조건을 고정합니다. “매출 데이터를 정리해 주세요”보다 어떤 표를 만들고 어떤 합계·중복·누락을 확인할지 구체화합니다.
- 대표 실행: 실제 전체 데이터나 모든 사용자를 한 번에 투입하지 말고, 목적을 대표하는 제한된 데이터와 하나의 명확한 outcome으로 시작합니다. 대표성이 부족하면 결과를 확장 결정의 근거로 쓰지 않습니다.
- 두 소비 성분: Capacity Metrics에서 Project Osmos 언어 모델 operation과 Spark 사용을 각각 확인합니다. 관찰 구간, 확인 시각, task 식별 정보를 함께 기록합니다.
- 귀속 한계: lakehouse 합계에 다른 task·사용자의 활동이 섞였는지, 보고 반영을 기다렸는지, 특정 task에 분리 귀속할 수 있는지를 적습니다. 확인되지 않으면 추정 배분하지 않습니다.
- capacity 영향: utilization, throttling, 바쁜 시간대, 동시 task 수, 제출 시차 계획을 capacity 관리자와 확인합니다. 별도 workspace가 같은 capacity를 쓰는 경우 이를 격리로 기록하지 않습니다.
- 결정과 재측정: “작업 시작”, “제한 파일럿”, “보류” 중 하나를 고르고, 최대 동시 task 수, 다음 측정 조건, capacity 담당자, 재검토일을 기록합니다. 조건이 달라지면 같은 결과로 간주하지 말고 다시 측정합니다.
기록 양식
목표·범위 / 대표 데이터와 task ID / 언어 모델 operation / Spark 관측값 / 공유 합계 귀속 여부 / 동시성·throttling 확인 / 결정·담당자·재측정일
기록 예시와 보류 조건
아래는 기록 방법을 보여주는 가상의 양식 예시이며 실제 Fabric 실행 결과나 성능 측정이 아닙니다. 월별 공급사 지출 Delta table을 만드는 작업을 검토한다고 가정해 보겠습니다.
- 목표·범위: 지정된 입력 테이블만 읽고, 검토용 산출 테이블과 notebook을 만들며, 합계 대사·중복 키·누락값을 확인합니다.
- 대표 실행: 비민감 대표 데이터로 제한된 outcome을 정의합니다. 데이터량, task 식별자, 실행 시각은 실제 환경에서 기록하며 이 예시에서는 미기록입니다.
- 소비 관찰: 언어 모델 operation과 Spark 사용을 따로 확인합니다. 어느 한쪽이라도 관찰되지 않았다면 수치를 만들어 채우지 않고 “미측정”으로 둡니다.
- 공유 상태: 같은 lakehouse를 사용하는 다른 task와 보고 지연을 확인합니다. task별 귀속이 불가능하면 공유 합계를 이 작업의 비용으로 배분하지 않습니다.
- 결정: 측정이 완성되기 전에는 확대를 보류합니다. 양쪽 경로와 capacity 상태를 확인한 뒤에만 제한 파일럿의 다음 조건과 담당자를 기록합니다.
이 중 하나라도 해당하면 확대를 멈추세요
- 대표 작업이 실제 목표를 대표하지 않거나 읽기·쓰기 경계가 정해지지 않았습니다.
- 언어 모델과 Spark 가운데 한 소비 성분을 관찰할 방법이 확인되지 않았습니다.
- 공유 lakehouse 합계를 근거 없이 한 task에 전부 귀속하고 있습니다.
- utilization·throttling 또는 동시 실행 수를 확인하지 않았습니다.
- 같은 capacity의 별도 workspace를 compute 격리로 오해하고 있습니다.
- preview 상태, 지역 제공 여부, SLA 부재를 검토하지 않은 채 production 사용을 전제로 하고 있습니다.
Microsoft 문서는 대표 작업으로 먼저 측정하고, 데이터량이나 동시 task를 늘리기 전에 두 소비 성분과 capacity 상황을 확인하도록 권고합니다. 따라서 “숫자가 아직 없지만 괜찮아 보인다”는 판단은 시작 근거가 아닙니다. 먼저 관측 경로와 책임자를 확보하세요.
자주 묻는 질문
Project Osmos는 토큰만 보면 되나요?
아닙니다. 언어 모델 operation과 Spark compute를 따로 살펴야 합니다. 코드 실행·실험·검증이 Spark 사용을 만들 수 있으므로 token 수만으로 전체 작업량이나 비용을 단정할 수 없습니다.
공유 lakehouse의 Spark 사용량을 task마다 정확히 나눌 수 있나요?
공식 문서는 공유 합계에 다른 task와 사용자 활동이 포함될 수 있다고 경고합니다. 환경에서 task별 분리가 검증되지 않았다면 정확히 나눌 수 있다고 가정하지 말고, 공유 합계와 귀속 한계를 함께 기록하세요.
같은 capacity 안에서 workspace를 분리하면 자원이 격리되나요?
아닙니다. 같은 capacity를 사용하는 별도 workspace는 compute isolation을 제공하지 않는다고 Microsoft의 모범 사례가 설명합니다. 격리가 필요하다면 capacity 관리자와 별도 capacity 배정 가능성을 검토해야 합니다.
작은 제한 파일럿이면 production에서 써도 되나요?
이 글의 제한 파일럿은 preview 범위 안에서 측정·운영 조건을 확인하는 평가를 뜻합니다. Project Osmos는 preview이며 production 용도로 의도되지 않고 SLA도 제공되지 않는다는 공식 주의사항을 먼저 확인하셔야 합니다.
참고 자료
- Microsoft Learn — What is Fabric data engineering agent (Project Osmos)?: Project Osmos의 persistent task, 실행 범위, 검증, preview 및 운영 제한을 확인할 수 있는 공식 개요입니다.
- Microsoft Learn — Project Osmos capacity consumption: 언어 모델과 Spark의 소비 구분, Capacity Metrics에서의 관찰 지점, 공유 lakehouse 합계의 귀속 및 반영 지연 주의사항을 다룹니다.
- Microsoft Learn — Project Osmos best practices: 작업 경계, 대표 데이터 측정, utilization·throttling 확인, task 제출 시차, 동시성 제한, workspace 격리 한계를 설명합니다.
세 자료는 모두 Microsoft의 공식 1차 문서입니다. 서로 다른 제3자 검증으로 간주하지 않았으며, 검색량·tenant별 비용·성능 수치나 특정 capacity 임계값은 이 문서에서 주장하지 않습니다.
이 글이 마음에 드세요?
FLOWIT on YouTube
영상으로도 FLOWIT을 이어서 보세요
AI 자동화, Claude Code, n8n, 데이터 분석 흐름을 블로그와 영상으로 함께 정리하고 있습니다.
Related Notes
같이 읽으면 좋은 FLOWIT 글
 Fabric Operations Agent, 알림이 곧 실행은 아닙니다: 상태·전환·행동 경계를 읽는 6칸 카드운영 조건을 감지했다고 곧바로 action을 허용할 수는 없습니다. Fabric Operations Agent의 상태·전환 조건, Teams 알림, creator 권한과 outbound 경계를 확인하는 6칸 운영 점검표입니다.
 GitHub 비활성 저장소, 보안은 언제 멈출까?GitHub 저장소가 조용해져도 Dependabot alerts, update PR, Code Scanning의 중단 기준은 서로 다릅니다. 1년·180일·90일의 활동 조건과 예외를 구분하고, 확인 증거와 다음 조치를 기록하는 운영…
 에이전트 레지스트리에 등록됐는데, 왜 MCP 도구 호출 권한은 따로 실패할까? 6칸 identity-resolution 영수증Google Cloud Agent Registry에서 agent나 MCP server가 보여도 호출 권한은 별도입니다. URN·resource name·principal·runtime reference를 6칸 영수증과 읽기 전용 허용·거부 테스트로 확인하세요.