먼저 답하면: 어제 데이터가 덜 들어왔을 가능성이 있으면, AI 분석 에이전트가 평소처럼 숫자를 답하게 두면 안 됩니다. 데이터의 최신성·규모·검증 결과를 허용·경고·차단·사람 검토의 네 가지 판정으로 바꾸고, 그 결과를 답변과 리포트 생성 직전에 적용해야 합니다.
“어제 매출이 얼마였나요?”라는 질문에 AI 분석 에이전트가 즉시 답하는 환경은 편리합니다. 하지만 특정 국가의 적재가 늦었거나 한 유입 채널의 데이터가 빠진 날에는, 전체 합계가 얼핏 정상처럼 보이더라도 답변의 전제가 무너질 수 있습니다.
이 글에서는 오래된 데이터·부분 누락·검증 실패를 AI 답변 직전의 릴리스 판정으로 연결하는 방법을 정리합니다. 핵심은 감시 화면을 하나 더 만드는 일이 아니라, 데이터셋이 지금 답변에 써도 되는 상태인지 명시적으로 판정하는 일입니다.
핵심 요약
- 최신성은 데이터가 약속한 시점까지 갱신됐는지 확인하는 신호입니다.
- 규모는 들어온 행 수나 금액이 평소 범위에서 크게 벗어나지 않았는지 확인하는 신호입니다.
- 기대값 검증은 필수 값, 허용 범위, 키 관계처럼 업무에 필요한 조건이 지켜졌는지 확인하는 신호입니다.
- 세 신호를 한 점수로 뭉개기보다, 허용·경고·차단·사람 검토의 행동으로 번역해야 합니다.
- 품질 통과만으로 지표 정의, 접근 권한, 업무 맥락까지 맞는 것은 아닙니다. 이 조건들은 별도로 확인해야 합니다.
왜 답변 전에 게이트가 필요할까요?
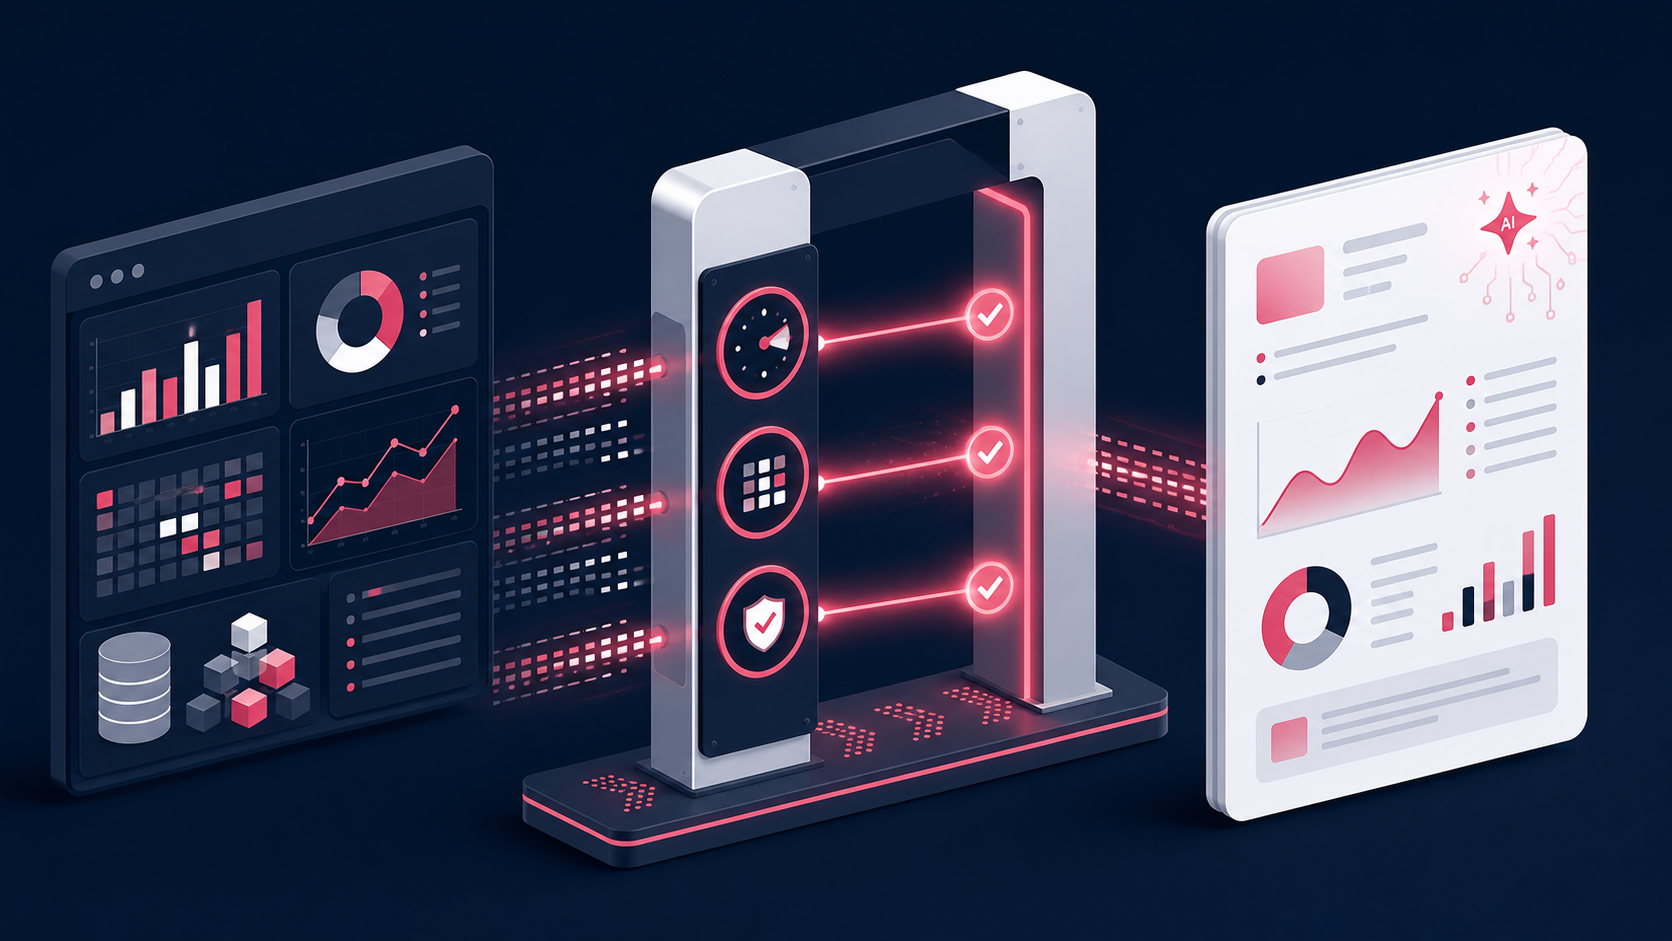
AI 분석 에이전트는 보통 저장소나 데이터 웨어하우스에서 값을 읽고, 그 값을 자연어로 설명합니다. 계산이 정확해도 입력 데이터가 늦거나 일부만 들어왔다면 결론은 신뢰하기 어렵습니다. 특히 자동 리포트는 사람이 표를 한 번 더 살피지 않고 전달되기 때문에, 데이터 문제를 답변 이후에 발견하는 비용이 커집니다.
Snowflake는 2026년 7월 공개 미리보기로 데이터 품질 모니터링 대시보드를 소개하면서 freshness anomaly, volume anomaly, failed expectation을 사고 분류에 활용할 수 있는 신호로 제시했습니다. 이는 특정 제품을 그대로 도입하자는 뜻이 아닙니다. 오히려 해당 공개 미리보기의 세 신호를 어떤 플랫폼에서도 답변 전 판정에 연결할 수 있다는 실무적 출발점으로 볼 수 있습니다.
최신성·규모·기대값·권한은 같은 문제가 아닙니다
최신성은 마지막 성공 갱신 시각이 약속한 범위를 넘겼는지 봅니다. 규모는 오늘의 행 수·금액·고유 사용자 수가 기준선에서 비정상적으로 멀어졌는지 봅니다. 기대값은 필수 국가 코드가 비어 있지 않은지, 음수이면 안 되는 값이 없는지처럼 정한 규칙의 통과 여부를 봅니다.
여기에 권한과 지표 정의를 별도 축으로 두어야 합니다. Databricks의 2026년 8월 릴리스 노트처럼 에이전트의 데이터 접근 통제와 거버넌스는 계속 변화합니다. 품질 판정이 통과했더라도 그 에이전트가 해당 데이터를 볼 권한이 있는지, “매출”이라는 지표가 동일한 정의인지까지 자동으로 보장되지는 않습니다.
AI 답변을 위한 4단계 릴리스 판정표
판정은 모호한 점수보다 행동을 정해야 운영됩니다. 아래 표는 조직의 SLA와 업무 위험도에 맞춰 조건을 채울 수 있는 기본 틀입니다.
| 판정 | 예시 신호 | 에이전트 행동 | 사용자에게 남길 문구 |
|---|---|---|---|
| 허용 | 갱신 시각·규모·필수 검증이 모두 기준 안 | 현재 데이터로 답변·리포트 생성 | “기준 시점까지 확인된 데이터입니다.” |
| 경고 | 비핵심 그룹 지연 또는 경미한 기준선 이탈 | 범위를 분명히 밝히고 조건부 답변 | “일부 범위는 갱신 중일 수 있어 해석에 주의가 필요합니다.” |
| 차단 | 핵심 데이터 지연, 필수 그룹 누락, 검증 실패 | 수치 결론·자동 발송을 중지 | “현재 데이터 상태로는 신뢰할 수 있는 답변을 제공할 수 없습니다.” |
| 사람 검토 | 신호가 충돌하거나 지표 정의·권한 확인이 필요 | 담당자에게 근거와 함께 검토 요청 | “데이터 상태와 적용 범위를 담당자가 확인하고 있습니다.” |
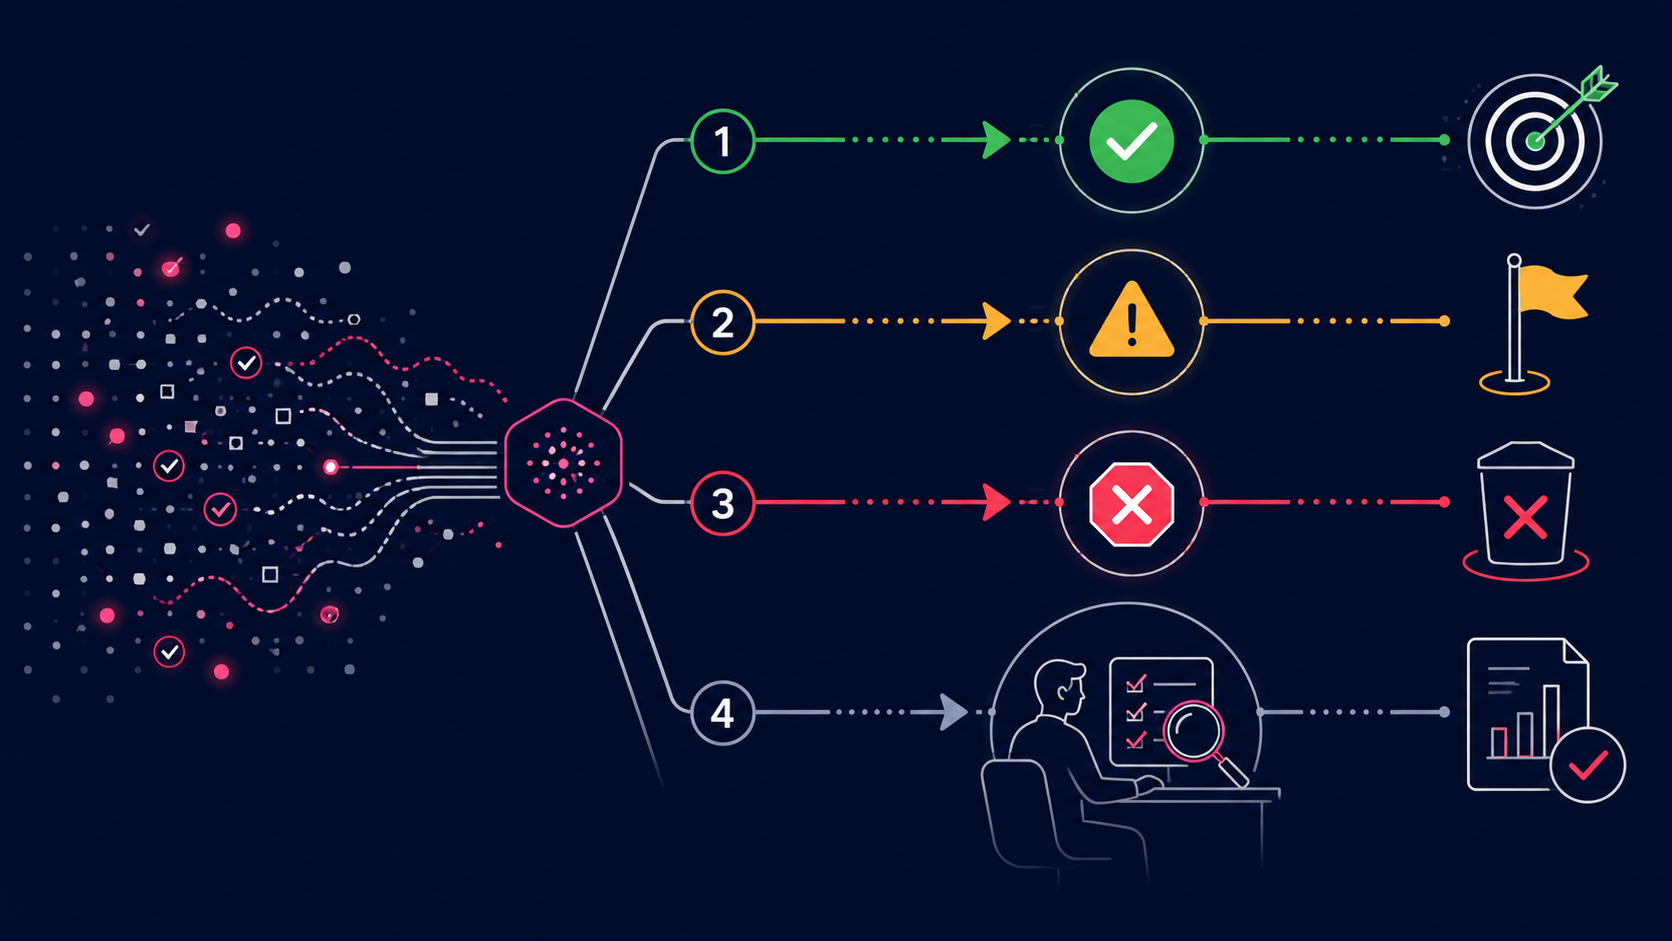
여기서 중요한 실패 조건이 있습니다. 경고를 기본값으로 남용하면 차단이 필요한 날에도 리포트가 나갑니다. 반대로 모든 작은 이상을 차단하면 현업이 우회 경로를 만들 수 있습니다. 핵심 지표와 비핵심 지표, 외부 공유 리포트와 내부 탐색 질문을 구분해 판정 기준을 정하는 편이 현실적입니다.
데이터셋마다 릴리스 카드를 남기세요
에이전트가 어떤 기준으로 멈췄는지 나중에 설명하려면, 데이터셋별 상태를 짧은 카드로 남겨야 합니다. 담당자가 바뀌어도 기준이 이어지고, 사고 뒤 재검증 범위도 좁힐 수 있습니다.
| 필드 | 예시 | 없을 때의 위험 |
|---|---|---|
| 담당자 | 매출 데이터 운영 담당 | 사고 알림이 멈추거나 잘못 전달됩니다. |
| 마지막 성공 갱신 | 검증을 통과한 마지막 적재 시각 | 오래된 스냅샷을 최신 데이터로 오해합니다. |
| 기준선 | 요일·국가·채널별 비교 범위 | 휴일과 부분 누락을 구분하기 어렵습니다. |
| 필수 검증 | 필수 그룹 존재, 값 범위, 중복 조건 | 그럴듯한 합계가 검증을 대신합니다. |
| 지표 버전과 사용 대상 | 정의 버전, 소비 에이전트 | 서로 다른 정의의 숫자가 섞입니다. |
Snowflake는 그룹 단위로 데이터 품질 검사를 적용하고 결과의 그룹 정보를 다루는 기능을 안내합니다. 그룹별 검사 관련 릴리스 노트가 보여 주듯, 전체 테이블 하나만 보는 방식보다 국가·채널·상품군처럼 실제 의사결정 단위로 상태를 확인하는 설계가 필요합니다.
사례: 전체 합계는 맞지만 특정 국가와 채널이 비어 있는 날
가령 전일 매출 리포트에서 국내 웹 채널은 들어왔고, 다른 유입 채널의 지연분이 국내 주문 증가로 우연히 상쇄됐다고 가정해 보겠습니다. 전체 합계만 보면 평소 범위에 있을 수 있습니다. 하지만 국가·채널별 상태를 보면 답변을 차단해야 할 수 있습니다.
| 점검 범위 | 상태 | 판정 | 후속 조치 |
|---|---|---|---|
| 전체 합계 | 기준선 안 | 단독으로는 판단 불가 | 그룹별 상태를 계속 확인 |
| 국가별 | 한 국가의 필수 레코드 미도착 | 차단 | 적재 상태 확인·재적재 요청 |
| 유입 채널별 | 외부 유입 채널의 값이 비어 있음 | 차단 또는 사람 검토 | 원천 시스템과 기준선 점검 |
| 상품군별 | 비핵심 상품군만 지연 | 경고 가능 | 제외 범위를 명시한 조건부 답변 |
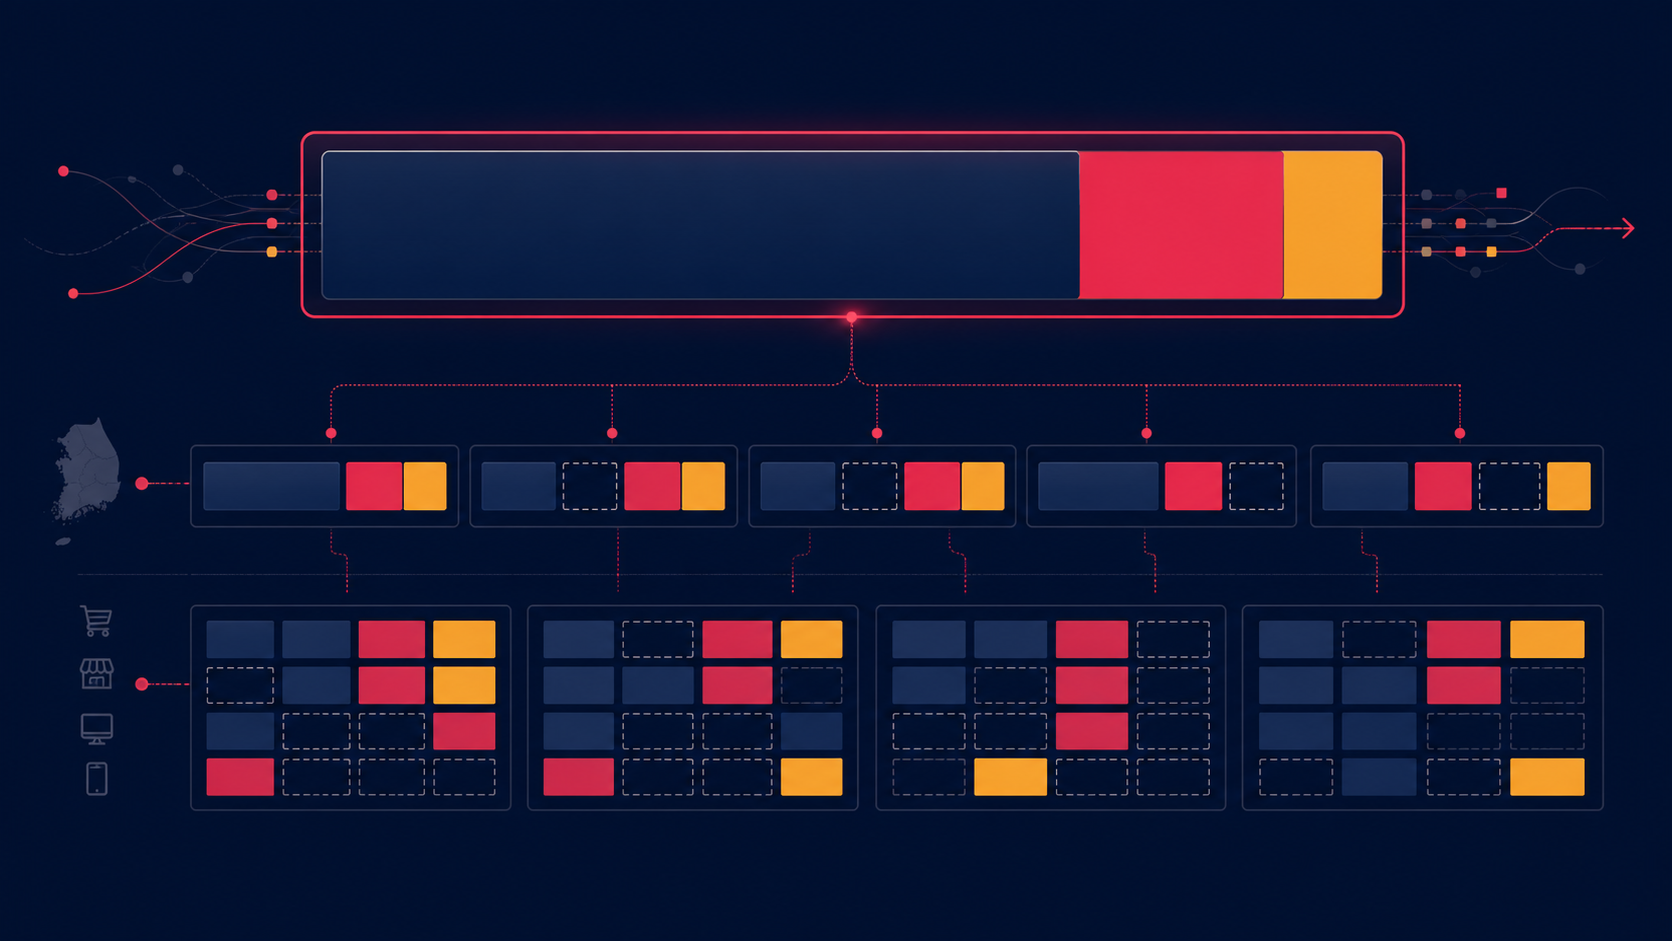
이 사례에서 비용은 도구 사용료만이 아닙니다. 잘못된 보고서를 바탕으로 예산을 조정하고, 이후 원인을 설명하고, 신뢰를 회복하는 시간이 더 큽니다. 그래서 중요한 리포트일수록 “마지막 갱신 시각”과 “답변에 포함된 범위”를 함께 남기는 편이 좋습니다.
사고 뒤에는 재검증과 재생성까지 연결하세요
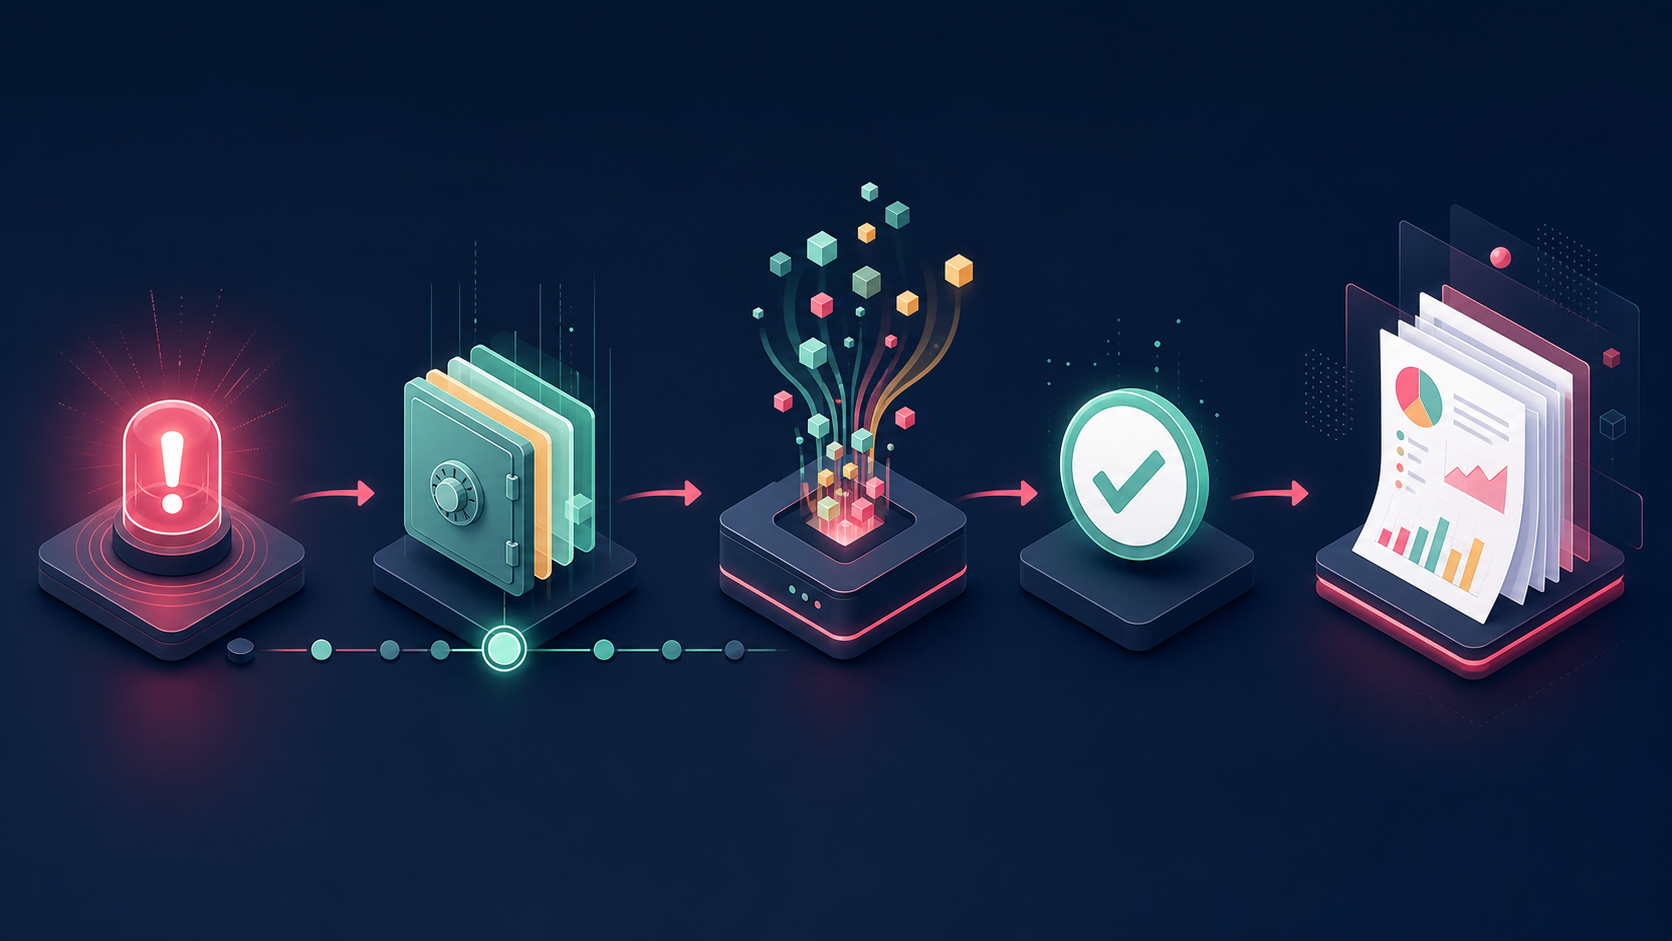
차단 상태를 만들었다고 끝난 것은 아닙니다. 정상화 뒤에도 이전에 생성된 요약문·파일·알림이 남아 있으면 같은 문제가 반복됩니다. 아래 순서대로 재가동하면 누가 무엇을 확인했는지 추적하기 쉬워집니다.
- 감지: 어떤 데이터셋, 어떤 그룹, 어떤 검증이 실패했는지 기록합니다.
- 안전한 기준 선택: 마지막 정상 스냅샷을 임시로 쓸지, 원천 재적재를 기다릴지 정합니다.
- 재검증: 최신성·규모·필수 검증과 그룹 커버리지를 다시 확인합니다.
- 재생성: 차단 중 만들어진 자동 리포트는 새 데이터로 다시 생성합니다.
- 범위 라벨 확인: 답변의 기준 시점, 포함·제외 범위, 지표 버전을 확인합니다.
운영 전 체크리스트
- 마지막으로 성공한 갱신 시각이 정해진 기준 안에 있나요?
- 오늘의 규모가 요일·시즌·그룹별 기준선에서 설명 가능한 범위인가요?
- 필수 값, 허용 범위, 중복·관계 조건이 통과했나요?
- 국가·채널·상품군처럼 중요한 그룹이 모두 포함됐나요?
- 이 리포트가 사용하는 지표 정의와 버전이 분명한가요?
- 문제가 생겼을 때 확인할 담당자와 재적재 경로가 있나요?
- 에이전트가 답변 시점과 포함 범위를 함께 말하도록 만들었나요?
입력 단계의 데이터 계약을 먼저 정리하고 싶다면 AI에게 CSV를 맡기기 전: 데이터 계약으로 엑셀·분석 자동화 오류를 막는 법도 함께 읽어 보세요. 데이터 구조와 정의를 잡은 뒤, 이 글의 릴리스 게이트로 운영 단계의 신뢰성을 이어갈 수 있습니다. 더 넓은 데이터 설계의 맥락은 AI 에이전트의 다음 경쟁력은 데이터 설계입니다에서 확인할 수 있습니다.
자주 묻는 질문
최신성만 확인하면 충분한가요?
아닙니다. 최신 데이터라도 일부 그룹이 빠졌거나 필수 규칙을 어겼을 수 있습니다. 최신성·규모·검증 결과를 함께 보되, 각각의 실패가 어떤 행동으로 이어지는지 정해 두는 편이 좋습니다.
모든 이상을 자동으로 차단해야 하나요?
그렇지는 않습니다. 핵심 지표와 외부 공유 리포트는 보수적으로, 영향이 작은 내부 탐색은 경고와 범위 라벨로 처리할 수 있습니다. 다만 차단 기준을 정하지 않은 경고는 사실상 허용이 되기 쉽습니다.
품질을 통과하면 숫자는 업무적으로 정답인가요?
아닙니다. 품질 통과는 정해 둔 조건을 만족했다는 뜻입니다. 지표 정의가 적절한지, 해당 사용자가 볼 권한이 있는지, 지금 질문의 업무 맥락에 맞는지는 별도 검토가 필요합니다.
그룹별 검사는 언제부터 필요한가요?
국가·채널·상품군처럼 일부 누락이 의사결정을 바꿀 수 있는 축이 있다면 필요합니다. 전체 합계 하나로 판단할 때 부분 누락이 가려질 가능성이 있다면 우선순위를 높이세요.
사고가 복구된 뒤 기존 리포트는 어떻게 해야 하나요?
재적재 성공만 확인하지 말고, 검증을 다시 통과한 데이터로 리포트를 재생성해야 합니다. 이전 결과물이 어디에 공유됐는지 확인하고 기준 시점과 범위를 다시 표시하세요.
참고 자료
- Snowflake: Data quality monitoring dashboard (Public Preview) — freshness anomaly, volume anomaly, failed expectation을 품질 사고 신호로 소개한 공식 릴리스 노트입니다.
- Snowflake: Apply data quality checks by group (GA) — 그룹 단위 품질 검사와 결과 정보를 다루는 기능의 공식 릴리스 노트입니다.
- Databricks AWS: August 2026 release notes — 에이전트 데이터 접근 통제와 거버넌스를 품질 판정과 별개로 검토해야 한다는 경계를 확인하는 공식 자료입니다.
이 글이 마음에 드세요?
FLOWIT on YouTube
영상으로도 FLOWIT을 이어서 보세요
AI 자동화, Claude Code, n8n, 데이터 분석 흐름을 블로그와 영상으로 함께 정리하고 있습니다.
Related Notes
같이 읽으면 좋은 FLOWIT 글
 AI 에이전트가 Colab 분석을 끝냈다면, 바로 믿어도 될까? 사람이 인수할 6칸 재현 카드AI 에이전트가 Colab에서 만든 분석 notebook을 사람이 인수할 때 확인할 목적·데이터 범위·실행 환경·변경 셀·결과 한계·재실행 계획을 6칸 카드와 10분 체크리스트로 정리합니다.
 AI 에이전트 스킬을 수정했는데 왜 팀마다 다르게 움직일까? 실행기별 계약 테스트로 배포하는 법공용 AI 에이전트 스킬과 지침을 수정할 때 실행기별 결과 차이를 줄이는 계약 테스트, 승격 조건, 롤백 체크리스트를 정리합니다.
 11월 전에 확인하세요: AI Builder 크레딧 종료로 Power Automate 자동화가 멈추지 않게 하는 점검표AI Builder 크레딧 종료 전 Power Apps와 Power Automate 자동화가 멈추지 않도록 계약 예외, 환경별 소비, Copilot Credits 대체 경로와 차단 테스트를 점검하는 실무…