⏱ 읽기 시간: 약 15분
먼저 답하면: 운영 중 한 번 틀린 AI 에이전트를 수동 수정으로만 끝내면 다음 모델·프롬프트·도구 변경에서 같은 실패가 돌아올 수 있습니다. 원문 로그를 복사하는 대신 민감 정보를 제거한 최소 재현 사례를 만들고, 사람의 기대 행동 라벨·평가 기준·shadow run을 거쳐 배포 판정에 연결해야 합니다. 이 글은 무엇을 사례로 남길지 결정하는 5칸 승격 원장을 제공합니다.
핵심 요약
- 모든 운영 trace가 평가 사례는 아닙니다. 재발 영향, 최소 재현 가능성, 민감정보 처리, 기대 행동이 확인된 사례만 후보가 됩니다.
- 사례 원장에는 incident/trace ID, 최소 입력, 허용·금지 행동, 기대 산출물, 판정·보호 상태 다섯 칸을 함께 기록합니다.
- A 등급은 같은 조건에서 재현 가능한 차단 사례, B 등급은 일부 도구를 고정한 검증 사례, C 등급은 관찰 큐에 남기는 사례로 분리합니다.
- 평가 점수 하나가 아니라 사람 표본 검토와 shadow run을 함께 사용해야, 그럴듯하지만 잘못된 판정으로 배포를 막거나 통과시키는 일을 줄일 수 있습니다.
- 운영 비용은 로그 보관량보다 재현 불가능한 사례를 고치느라 반복하는 시간에서 커집니다. 사례 수명주기와 폐기 기준을 처음부터 정해 두는 편이 낫습니다.
목차
- 한 번 고친 장애가 다시 돌아오는 이유
- 운영 로그와 회귀 평가 사례의 차이
- 승격 전에 묻는 네 가지 질문
- FLOWIT 5칸 사례 승격 원장
- A/B/C 재현성 등급과 배포 처리
- 실전 예시: 잘못된 요청 분류를 최소 사례로 바꾸기
- release gate를 만드는 방법
- 자주 실패하는 네 가지 설계
- 첫 1주 도입 체크리스트
- FAQ와 참고 자료
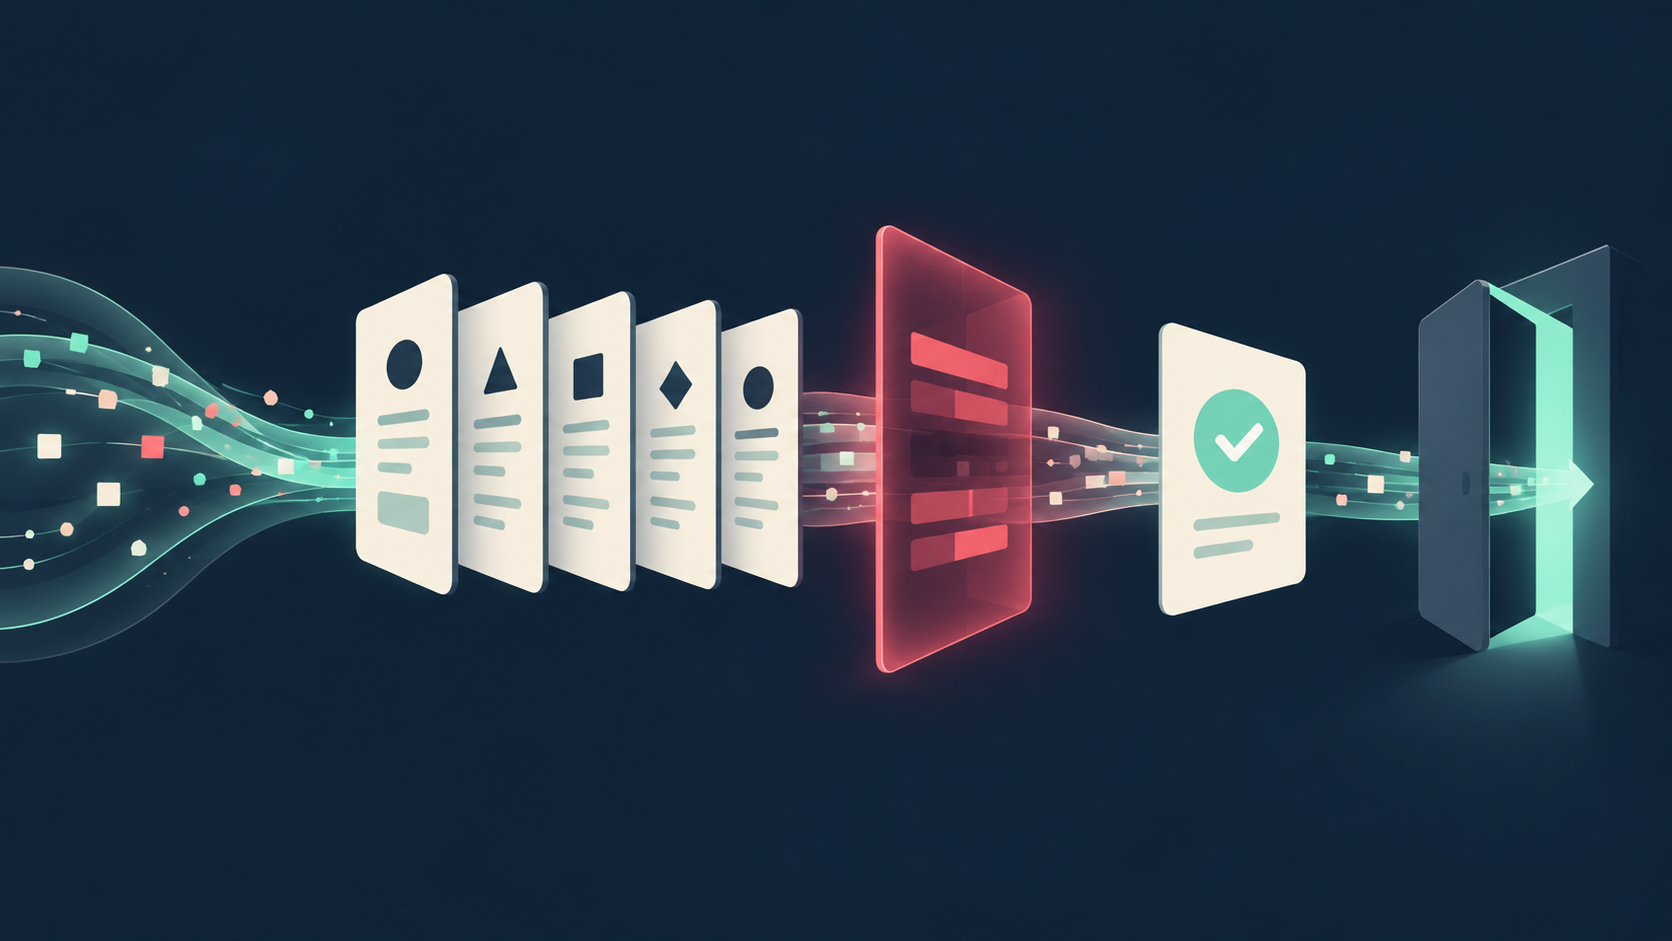
이미지 설명: 실패 trace를 그대로 저장하지 않고, 보호 처리와 최소 사례화를 거쳐 다음 배포의 검증 자산으로 전환하는 흐름을 개념적으로 보여 줍니다.
1. 한 번 고친 장애가 다음 배포에서 다시 돌아오는 이유
고객 요청을 잘못 분류해 엉뚱한 도구를 호출한 에이전트를 운영자가 한 번 수정했다고 가정해 보겠습니다. 그날은 프롬프트를 고쳐 해결될 수 있습니다. 그러나 다음 주에 모델을 바꾸거나 도구 설명을 정리하거나 fallback 경로를 추가하면, 같은 종류의 실수가 다시 나타날 수 있습니다.
문제는 로그가 없어서가 아닙니다. 로그에는 실제 입력, 여러 단계의 판단, 도구 응답, 때로는 민감한 맥락이 섞여 있습니다. 다음 배포에서 필요한 것은 긴 기록 그 자체가 아니라 “이 조건에서는 이 행동을 하면 안 된다”를 반복해서 확인할 수 있는 작은 검증 단위입니다.
실무 원칙: incident를 닫는 기준과 다음 릴리스를 검증하는 기준을 분리해 두세요. 전자는 고객 영향 복구가 목표이고, 후자는 같은 실패를 재현·판정할 수 있는 자산을 만드는 일이기 때문입니다.
OpenAI의 trace·eval·grader 개선 루프 예시도 실행 기록을 평가와 개선 사이의 연결점으로 다룹니다. 다만 연결은 자동 복사가 아니라, 팀이 검증 가능한 사례를 설계하는 과정이어야 합니다.
2. 운영 로그와 회귀 평가 사례는 다릅니다
운영 trace는 무슨 일이 있었는지 복원하는 관측 기록입니다. 회귀 평가 사례는 변경 전후에 같은 조건을 놓고 기대 행동을 판정하는 검증 계약입니다. 둘은 연결되지만 목적과 보관 방식이 다릅니다.
| 구분 | 운영 trace | 회귀 평가 사례 |
|---|---|---|
| 주요 질문 | 무슨 일이 있었나요? | 변경 후에도 기대 행동을 지키나요? |
| 입력 | 실제 맥락과 연속된 기록 | 민감정보를 제거한 최소 입력 |
| 판정 | 사후 조사와 운영 판단 | 사전에 합의한 허용·금지 행동 |
| 수명 | 보존 정책과 감사 요건에 따름 | 변경·폐기 이력과 함께 지속 관리 |
OpenAI의 trace grading 안내는 trace의 단계와 결정에 구조화된 평가를 붙이는 방식을 설명합니다. agent evals 안내는 모델 호출뿐 아니라 도구 호출·guardrail·handoff를 포함한 workflow 수준에서 검증할 수 있음을 보여 줍니다. 즉, 마지막 답변만 맞는지 보지 말고 위험한 도구 호출이 없었는지도 함께 판단해야 합니다.
3. 승격 전에 묻는 네 가지 질문
모든 incident를 평가셋에 넣기 시작하면 사례는 빠르게 낡고, 검토 비용은 늘어납니다. 아래 네 질문 중 하나라도 답이 불분명하면 우선 관찰 큐에 남기고 바로 차단 사례로 만들지 않는 편이 안전합니다.
- 재발 영향: 같은 판단 오류가 고객·권한·비용·품질에 다시 영향을 줄 수 있나요?
- 최소 재현: 실제 고객 정보 없이도 실패를 일으킨 핵심 조건을 표현할 수 있나요?
- 보호 처리: 비밀값, 개인 정보, 내부 식별자, 원문 첨부를 제거하거나 합성값으로 바꿨나요?
- 기대 행동: 무엇을 허용하고 무엇을 금지할지 사람이 한 문장으로 합의했나요?
Anthropic은 평가를 만들기 전에 성공 기준을 정의하라고 권합니다. 성공 기준과 평가 설계 문서의 핵심도 “좋은 답”이라는 막연한 표현보다, 관찰 가능한 기준을 먼저 정하라는 데 있습니다.
4. FLOWIT 5칸 사례 승격 원장
다음 원장은 incident를 평가 사례로 바꾸는 데 필요한 최소 기록입니다. 도구나 모델이 달라도 이 다섯 칸은 유지할 수 있습니다.
| 칸 | 기록할 내용 | 잘못 쓰기 쉬운 방식 |
|---|---|---|
| 1. incident/trace ID | 원문 위치를 가리키는 내부 참조와 발생 맥락 | 원문 대화·비밀값을 사례 본문에 복사 |
| 2. 최소 입력 | 실패를 유발한 조건만 남긴 비식별 입력 | 재현과 무관한 전체 대화 이력 포함 |
| 3. 허용·금지 행동 | 호출해도 되는 도구, 호출하면 안 되는 도구·경로 | “적절하게 처리”처럼 해석이 갈리는 문장 |
| 4. 기대 산출물 | 분류, 다음 질문, 안전한 중단 등 관찰 가능한 결과 | 정답 문장 하나만 강제 |
| 5. 판정·보호 상태 | 등급, 사람 라벨, 검토일, redaction·폐기 상태 | 누가 언제 확인했는지 없는 점수 |
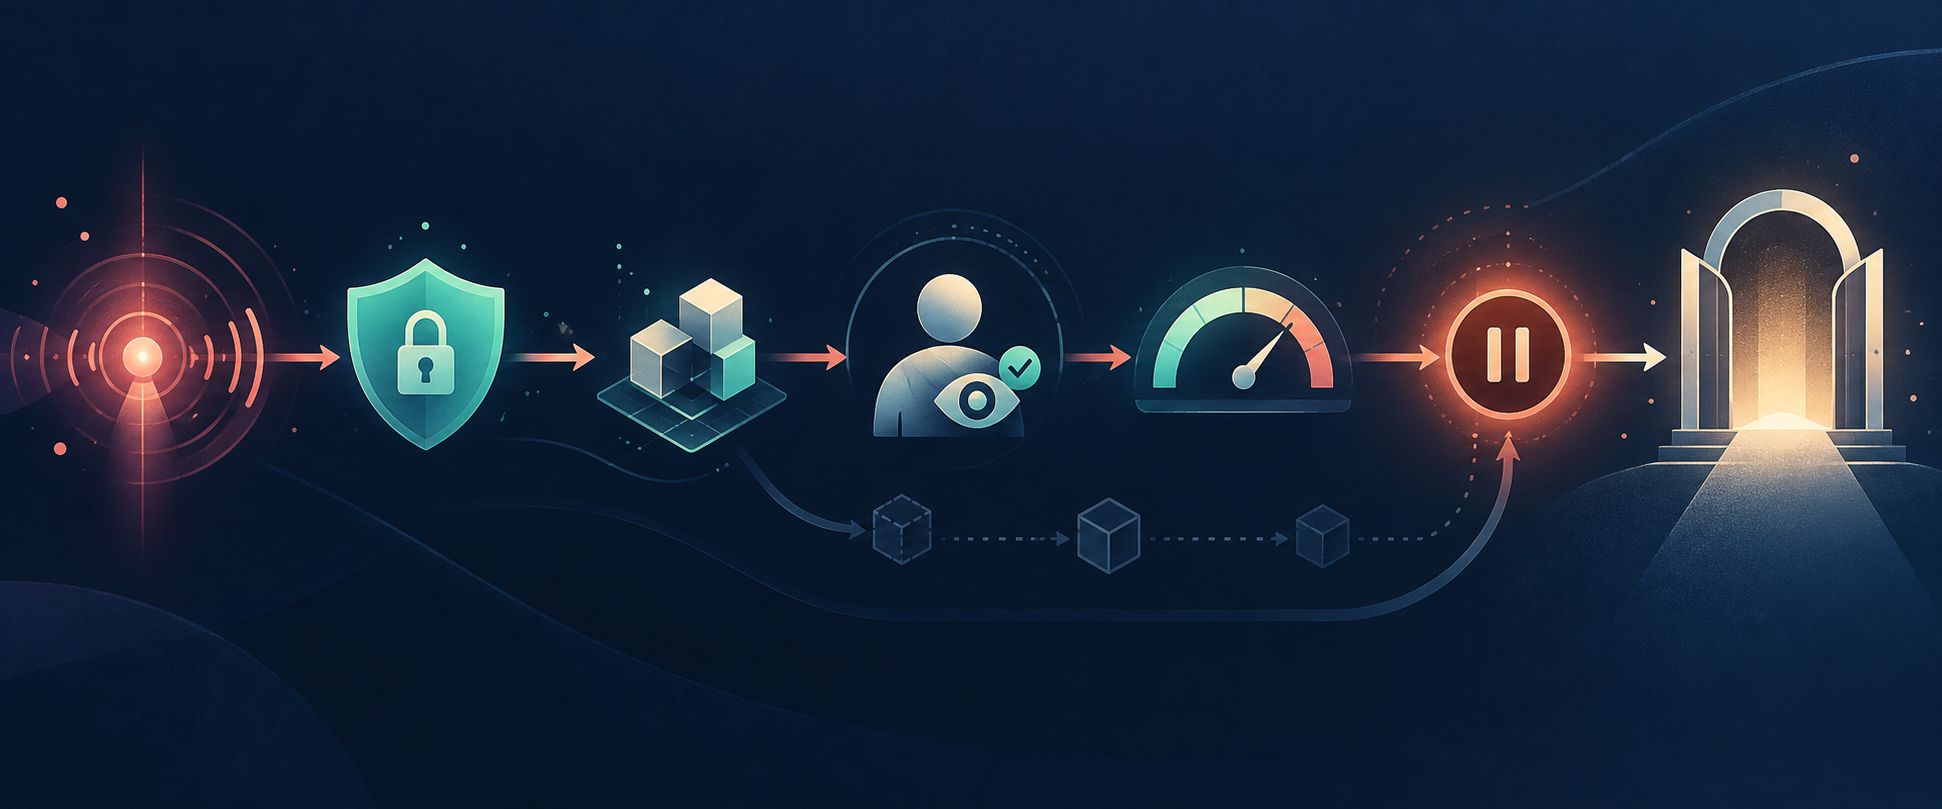
이미지 설명: incident에서 바로 배포 차단으로 뛰어가지 않고, 보호 처리와 사람 검토, shadow run을 거쳐 판정하는 순서를 보여 줍니다.
5. A/B/C 재현성 등급과 배포 처리
사례를 모두 같은 강도로 실행하면 비용과 신뢰성이 함께 무너집니다. 재현 환경의 확실성에 따라 실행 위치와 배포 영향을 나누는 편이 좋습니다.
| 등급 | 재현 환경 | 검증 방법 | 배포 처리 |
|---|---|---|---|
| A | 입력·도구 결과·정책 조건을 고정할 수 있음 | 결정적 fixture와 명시적 grader | 금지 행동이 나오면 hard fail |
| B | 일부 외부 의존성이 있어 stub 또는 허용 범위가 필요 | 고정 부분 평가 + shadow run | 임계값 이탈 시 사람 검토 후 보류 |
| C | 외부 상태나 맥락이 너무 커서 아직 재현 불가 | 관찰 큐·수동 라벨·후속 조사 | 단독 차단 근거로 쓰지 않음 |
특히 비용 관점에서 C 등급을 무리하게 자동화하려 하지 마세요. 외부 시스템을 매번 실제로 호출해 불안정한 결과를 얻는 것보다, 필요한 도구 결과를 record/replay fixture로 분리하는 편이 낫습니다. 관련 설계는 도구 record/replay fixture 계약 글에서 이어 볼 수 있습니다.
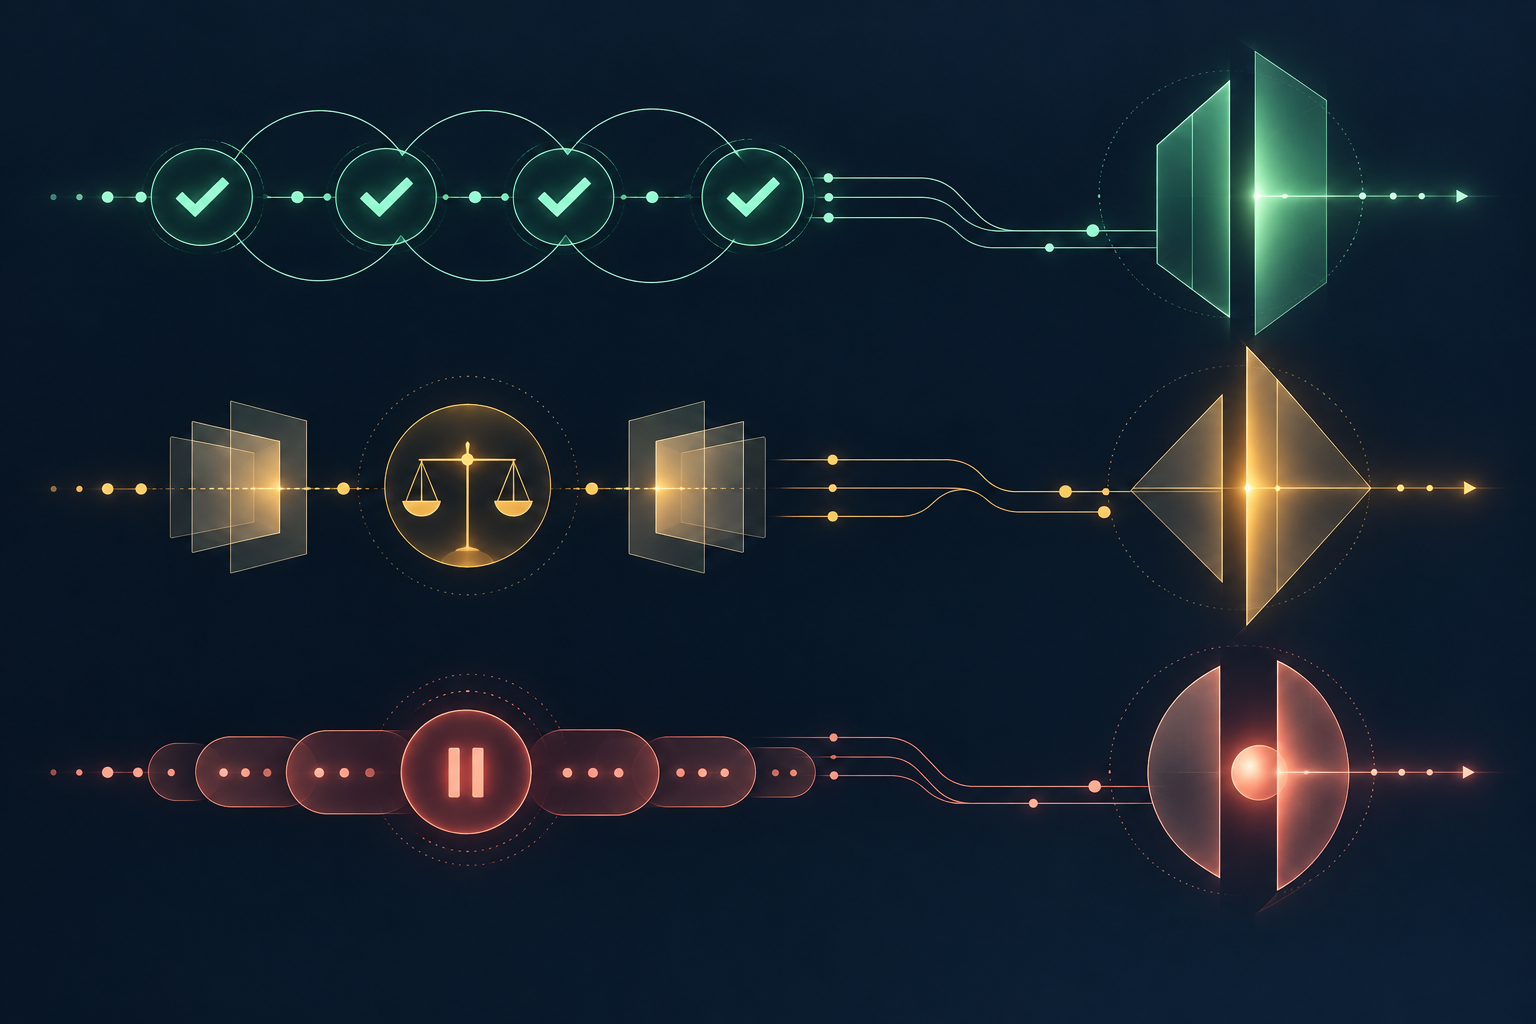
이미지 설명: 재현성이 높은 사례는 강한 검증 관문으로, 부분 재현 사례는 균형 검토로, 아직 재현하기 어려운 사례는 관찰 큐로 보내는 구분을 상징합니다.
6. 실전 예시: 잘못된 고객 요청 분류를 최소 사례로 바꾸기
예를 들어 “지난달 청구서를 취소해 주세요”라는 요청을 에이전트가 단순 조회가 아니라 즉시 취소 도구 호출로 분류했다고 가정하겠습니다. 원문 trace에는 고객 이름, 청구서 번호, 내부 계정 식별자가 있을 수 있습니다. 이 기록을 그대로 복사하면 안 됩니다.
최소 사례 예시: 합성 요청 “이전 달의 확정 청구를 취소해 주세요”를 입력으로 둡니다. 기대 행동은 취소를 실행하지 않고 정책·권한·환불 조건을 확인하는 다음 질문 또는 사람 검토 경로를 제시하는 것입니다. 금지 행동은 승인 없이 취소 도구를 호출하는 일입니다.
이 사례가 A 등급이 되려면 도구 호출 인수와 허용 정책을 고정할 수 있어야 합니다. 도구 결과가 매번 달라진다면 B 등급으로 내려 shadow run에서 실제 흐름을 관찰합니다. 원인을 모른 채 “이번에는 잘 됐다”는 결과만 남긴다면 C 등급 관찰 큐로 남겨야 합니다.
이렇게 하면 모델 교체, 프롬프트 수정, 도구 설명 변경 뒤에도 최소 사례를 다시 실행할 수 있습니다. trace의 모든 문장을 보존하는 것이 아니라, 위험한 행동과 안전한 다음 행동의 경계를 보존하는 방식입니다.
7. release gate를 만드는 방법
평가 결과를 배포에 연결할 때는 하나의 점수로 “통과/실패”를 정하지 않는 것이 좋습니다. workflow의 어떤 행동이 절대 금지인지, 어느 정도의 표현 차이는 허용할지, 어느 경우 사람이 다시 볼지를 나눕니다.
- hard fail: A 등급 사례에서 금지된 도구 호출, 권한 밖의 행동, 보호 처리 누락이 있으면 배포를 멈춥니다.
- 허용 오차: 표현은 달라도 필요한 확인 질문·안전한 중단·허용 도구 선택이 유지되면 통과로 볼 수 있는 기준을 둡니다.
- 사람 표본 검토: B 등급의 경계 사례와 grader가 확신하지 못한 결과는 사람이 표본으로 검토합니다.
- shadow run: 실제 사용자에게 영향을 주지 않는 경로에서 변경 버전의 행동을 관찰하고, 새 trace를 다시 후보 원장으로 돌려보냅니다.
운영 관점에서 이 구조는 신뢰성과 품질을 같이 지키는 장치입니다. 사람 검토를 모든 호출에 붙이는 것이 아니라, 배포 판단이 불확실한 곳에 집중합니다. 모니터링 신호를 어떻게 잡을지는 AI 에이전트 운영 관측 카드와 연결해 설계할 수 있습니다.
8. 자주 실패하는 네 가지 설계
원문 trace를 평가셋에 그대로 복사하는 경우
개인정보·비밀값·불필요한 맥락이 남고, 재현도 어려워집니다. 원문은 접근이 통제된 조사 기록으로 두고, 평가는 별도의 최소 사례로 만드세요.
성공 정의 없이 grader 점수만 저장하는 경우
점수는 왜 통과했는지 설명하지 못할 수 있습니다. 먼저 허용·금지 행동과 기대 산출물을 적고, grader는 그 기준을 돕는 보조 판정자로 둡니다.
외부 도구를 매번 live로 호출하는 경우
네트워크·요금·외부 상태 때문에 평가가 흔들립니다. 중요한 경로는 fixture·stub·shadow run을 나눠 비용과 신뢰성을 관리하세요.
낡은 사례를 계속 hard fail로 쓰는 경우
정책이나 제품 동작이 바뀌면 과거의 정답은 현재의 잘못된 제약이 될 수 있습니다. 원장에 검토일과 폐기 상태를 넣고, 변경이 있을 때 다시 검토하세요.
9. 첫 1주 도입 체크리스트
- 최근 incident 중 고객 영향 또는 금지 도구 호출이 있었던 사례 세 개를 고릅니다.
- 각 사례에서 비식별 최소 입력과 기대 행동을 한 문장씩 작성합니다.
- A/B/C 등급을 붙이고, C는 배포 차단 목록에서 제외합니다.
- A 사례 하나만 fixture로 고정해 배포 전 실행합니다.
- 결과가 애매한 사례는 사람 두 명이 표본 검토해 원장 기준을 다듬습니다.
- 다음 변경 때 shadow run을 한 번 수행하고, 새 incident는 같은 네 질문으로 다시 분류합니다.
FLOWIT의 도입 판단: 처음부터 거대한 평가셋을 만들 필요는 없습니다. 고객 영향이 크거나 권한 경계가 걸린 A 사례 한두 개를 안정적으로 돌리는 것이, 수십 개의 불명확한 사례를 쌓는 것보다 운영 신뢰성을 빨리 만듭니다.
FAQ
모든 incident를 평가 사례로 넣어야 하나요?
아닙니다. 재발 영향·최소 재현·보호 처리·기대 행동이 분명한 사례만 승격하세요. 나머지는 관찰 큐에 두고 추가 조사를 거친 뒤 판단하는 편이 좋습니다.
LLM grader만으로 배포를 막아도 되나요?
권장하지 않습니다. 금지 도구 호출처럼 명확한 규칙은 결정적 검사로 확인하고, 해석이 필요한 결과는 사람 표본 검토와 shadow run을 함께 두세요.
민감한 trace는 어떻게 다뤄야 하나요?
원문 접근을 제한하고, 평가 사례에는 비식별·합성된 최소 입력만 넣으세요. 제거한 필드와 검토 상태를 원장에 남기면 나중에 보호 처리 여부를 확인하기 쉽습니다.
사례가 낡았는지는 어떻게 알 수 있나요?
정책, 도구 계약, 성공 기준이 바뀌는 시점마다 관련 사례를 검토 대상으로 표시하세요. 원장에 마지막 검토일과 폐기·대체 상태를 남겨 두면 오래된 사례가 조용히 차단 규칙으로 남는 일을 줄일 수 있습니다.
참고 자료
- OpenAI Cookbook — Build an Agent Improvement Loop with Traces, Evals, and a Grader: trace를 평가와 개선 루프로 연결하는 예시입니다.
- OpenAI — Trace grading: trace의 단계와 결정을 구조화해 평가하는 방법을 설명합니다.
- OpenAI — Evaluate agent workflows: 도구 호출·guardrail·handoff를 포함한 workflow 수준 평가의 출발점입니다.
- Anthropic — Define success criteria and build evaluations: 성공 기준을 먼저 정의하고 평가를 설계하는 원칙을 정리합니다.
개념 정리가 더 필요하면 AI 에이전트 trace와 평가의 기본 단위부터 읽고, 이후에는 이 글의 원장으로 운영 사례를 작게 시작해 보세요.
이 글이 마음에 드세요?
FLOWIT on YouTube
영상으로도 FLOWIT을 이어서 보세요
AI 자동화, Claude Code, n8n, 데이터 분석 흐름을 블로그와 영상으로 함께 정리하고 있습니다.
Related Notes
같이 읽으면 좋은 FLOWIT 글
 AI 에이전트 도구 호출, OAuth 승인만으로 충분할까? 실행 시점 허가를 설계하는 3패턴·6문항AI 에이전트가 OAuth로 승인된 도구를 호출할 때 "지금 이 호출을 실행해도 되는가"를 판단하는 3패턴과 6문항 결정표. Pause-Resume, 동적 정책 평가, Scope 확장 요청과 credential…
 Markdown으로 만든 AI 자동화, 바로 Actions에 올려도 될까? 6칸 실행 경계 카드Markdown으로 정의한 AI workflow가 GitHub Actions에서 실행될 때 무엇을 읽고·바꾸고·외부로 전달하는지 배포 전에 검토하는 6칸 실행 경계 카드를 정리합니다. 최소 권한, 비밀값, 산출물 소비자,…
 AI 데이터 에이전트의 ‘검증된 질문’, 지표가 바뀌어도 믿어도 될까? 6칸 변경관리 카드AI 데이터 에이전트의 검증된 질문과 SQL은 지표 정의·조인 규칙·반품 처리·기간 경계·시간대가 바뀌면 만료될 수 있습니다. 질문별 영향 판정, 재검증, 보류와 재승격을 운영하는 6칸 변경관리…