먼저 답부터 말씀드리면: 데이터를 복제하지 않고 여러 클라우드를 조회하는 방식은 파일 이동과 동기화 부담을 줄일 수 있습니다. 하지만 그것만으로 원본·기존 리포트·연합 조회가 같은 KPI를 말한다는 뜻은 아닙니다. 한 KPI를 읽기 전용으로 대조하는 6칸 지표 일치 카드가 채워졌을 때만 제한 파일럿으로 넘어가세요.
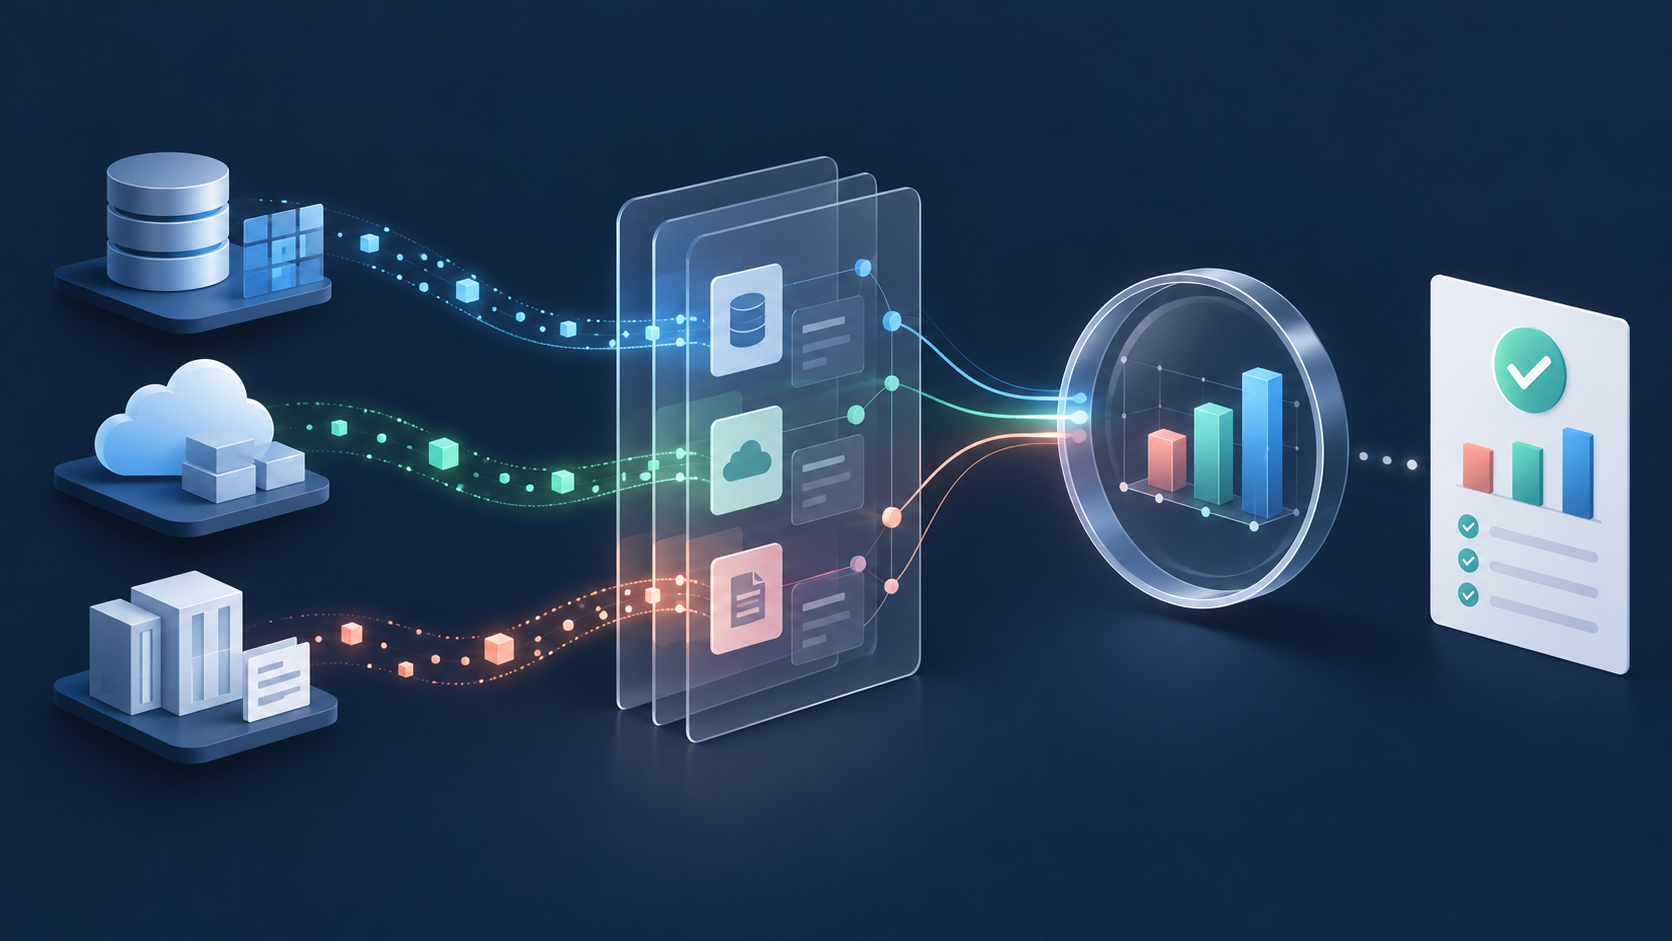
AI 데이터 에이전트가 여러 클라우드의 데이터를 한곳에 복제하지 않고 바로 분석하자고 제안할 때, 정말 도입해도 될까요? 가능은 하지만, 먼저 ‘같은 숫자를 보고 있는가’를 증명해야 합니다. 이 글에서는 중앙 복제·제한 파일럿·도입 보류 중 하나를 고르기 위해, 한 KPI를 기준으로 확인할 실무 절차를 정리합니다.
핵심 요약
- 연합 조회는 데이터 이동을 줄이는 접근이지, KPI 의미와 결과를 자동으로 맞춰 주는 장치는 아닙니다.
- 첫 검증은 한 도메인·한 KPI·읽기 전용으로 작게 시작해야 원인을 분리할 수 있습니다.
- 숫자가 다르면 플랫폼을 탓하기 전에 정의, grain, 필터, 시간대, snapshot 시점 순서로 확인하세요.
- 접근 권한·실행 비용·실패 로그·기존 리포트로 돌아갈 방법까지 남겨야 운영 가능한 파일럿이 됩니다.
데이터를 옮기지 않아도 숫자가 달라지는 이유
Google Cloud는 Borderless Lakehouse 사례에서 외부 Apache Iceberg REST 카탈로그의 메타데이터를 동기화하고, 원격 객체 저장소의 데이터를 제자리에서 읽는 패턴을 설명합니다. 이 구조는 중앙 스테이징을 위해 파일을 반복 복제하는 부담을 줄일 수 있습니다. 다만 메타데이터 동기화와 실제 저장소 접근은 분리된 단계입니다. 그러므로 “쿼리가 실행됐다”는 결과만으로 보고서의 숫자까지 동등하다고 판단하면 안 됩니다.
예를 들어 기존 매출 리포트가 주문 완료 시각 기준, KST 기준일, 환불 제외 조건으로 집계된다고 가정해 보겠습니다. 연합 조회가 결제 승인 시각, UTC 날짜, 다른 상태 필터를 사용하면 쿼리 자체는 정상이어도 결과는 달라집니다. 이것은 어느 한 플랫폼의 결함이라기보다 지표의 약속이 아직 맞춰지지 않은 상태입니다.
“이 결과가 맞나요?”보다 “어느 시점의 어떤 행을, 어떤 규칙으로 같은 KPI라고 부르나요?”를 먼저 고정하세요.
연합 조회 전 6칸 지표 일치 카드
도입 판단은 제품 기능 목록이 아니라 증거 카드로 남기는 편이 안전합니다. 아래 여섯 칸이 비어 있다면 중앙화가 아니라 제한 파일럿 또는 보류가 맞습니다.
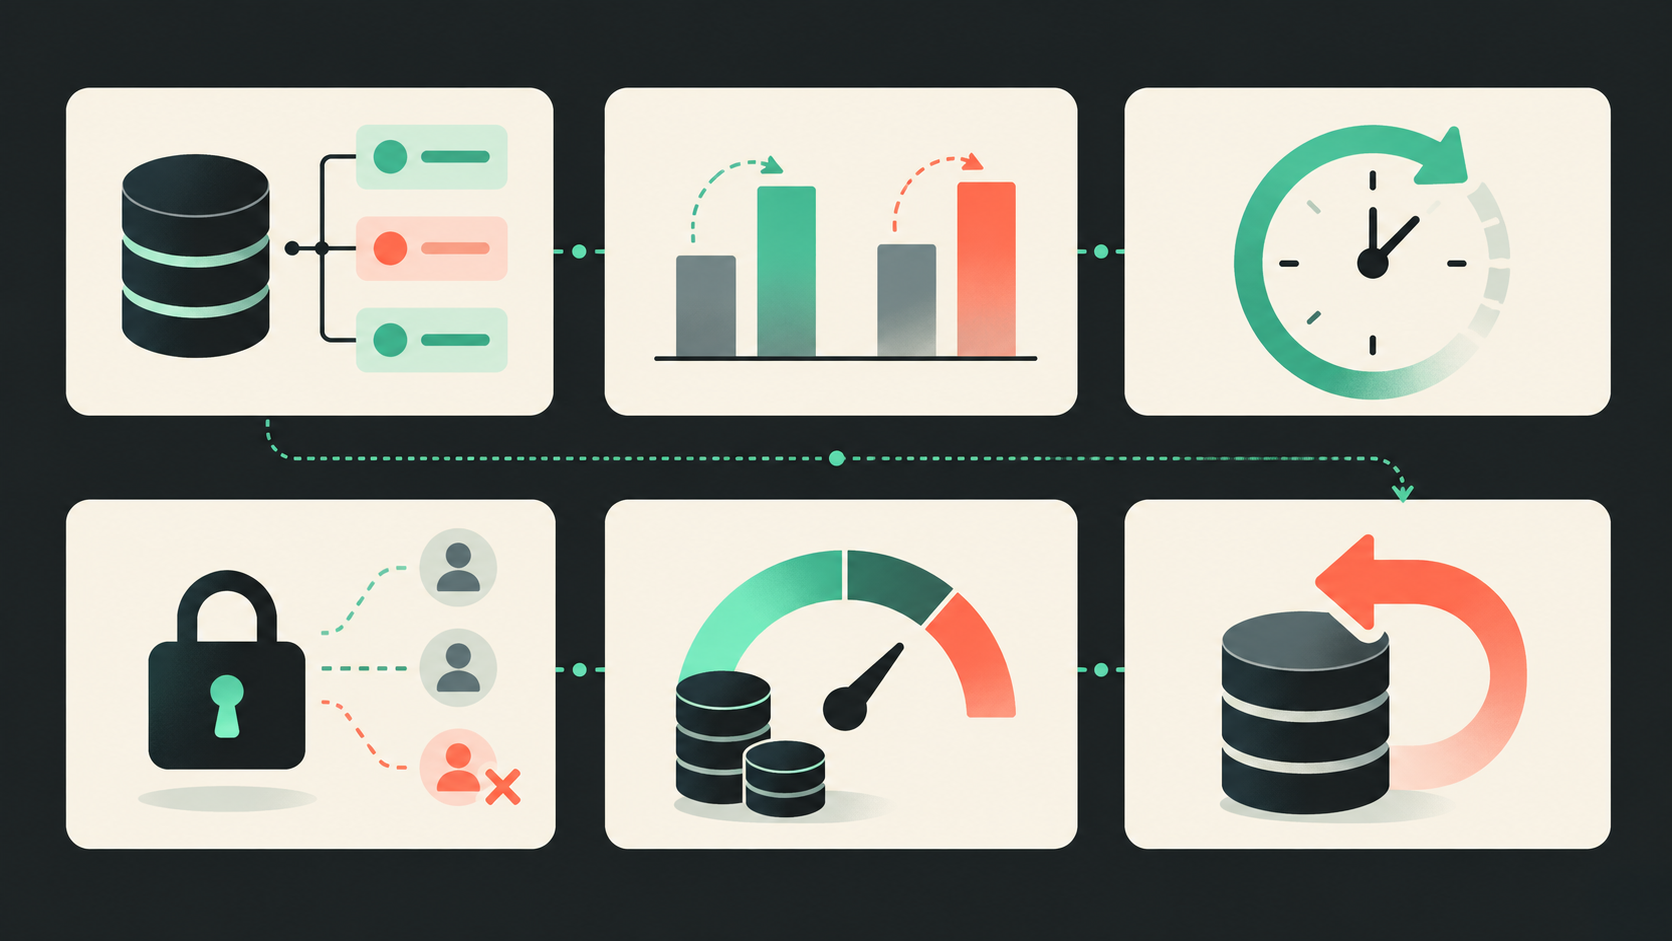
- 기준 지표
KPI 이름뿐 아니라 정의, grain, 기간, 필터, 시간대, 담당자를 기록합니다. - 결과 대조
원본·기존 리포트·연합 조회에 같은 조건을 적용하고, 사전에 합의한 허용 오차와 함께 값을 남깁니다. - freshness
원본 데이터 도착 시각, metadata refresh 또는 snapshot 시각, 조회 시각을 한 줄로 연결합니다. - 권한 경계
어느 namespace·table·column을 읽는지와 서비스 계정 또는 credential의 범위를 최소 권한 관점에서 설명합니다. - 비용과 실패 기록
실행 시간·처리량·네트워크 비용 가능성·실패 로그의 담당자를 남깁니다. 한 번의 성공은 평균 비용이나 안정성의 증거가 아닙니다. - rollback
불일치나 권한 문제 시 어떤 기존 리포트로 돌아가며, 누가 중단 결정을 내리는지 정합니다.
dbt의 데이터 테스트 문서는 검증을 “실패 행을 찾는 assertion”으로 설명합니다. 이 관점을 가져오면 단순히 두 숫자가 같았다는 기록보다, 불일치가 생겼을 때 어떤 행과 조건을 다시 볼지 남길 수 있습니다.
예시: 활성 고객 수 하나만 읽기 전용으로 대조하기
처음부터 여러 도메인을 묶지 마세요. 예를 들어 주간 활성 고객 수 하나만 골라 다음과 같이 파일럿을 설계할 수 있습니다.
| 원본 기준 | 연합 조회에서 확인할 값 | 판정 증거 |
|---|---|---|
| 활성 고객의 정의, 고객 ID grain, KST 주간 범위, 제외 상태 | 동일한 정의와 필터를 쿼리에 명시했는가 | 정의 문서 링크와 검토자 |
| 기존 검증 리포트의 결과 | 동일 기간의 연합 조회 결과와 허용 오차 | 두 결과, 비교 시각, 불일치 행 수 |
| 원본 적재 완료 시각 | 카탈로그 metadata·snapshot과 실제 조회 시각 | 세 시각을 적은 실행 기록 |
| 기존 리포트 접근 범위 | 읽기 전용 계정의 table·column 접근 범위 | 권한 검토와 만료·중단 절차 |
이 파일럿에서 중요한 것은 결과값 자체보다 비교를 다시 실행할 수 있는 조건입니다. 기간을 바꾸거나 필터를 숨긴 채 “대체로 비슷하다”고 결론 내리면, 나중에 에이전트가 자연어 요청을 쿼리로 바꿀 때 어떤 기준선에서 벗어났는지 알 수 없습니다.
짧은 수명의 자격증명이나 카탈로그 연결이 자동으로 최소 권한을 보장하지는 않습니다. 파일럿에는 필요한 읽기 범위와 중단 조건을 따로 적어 두세요.
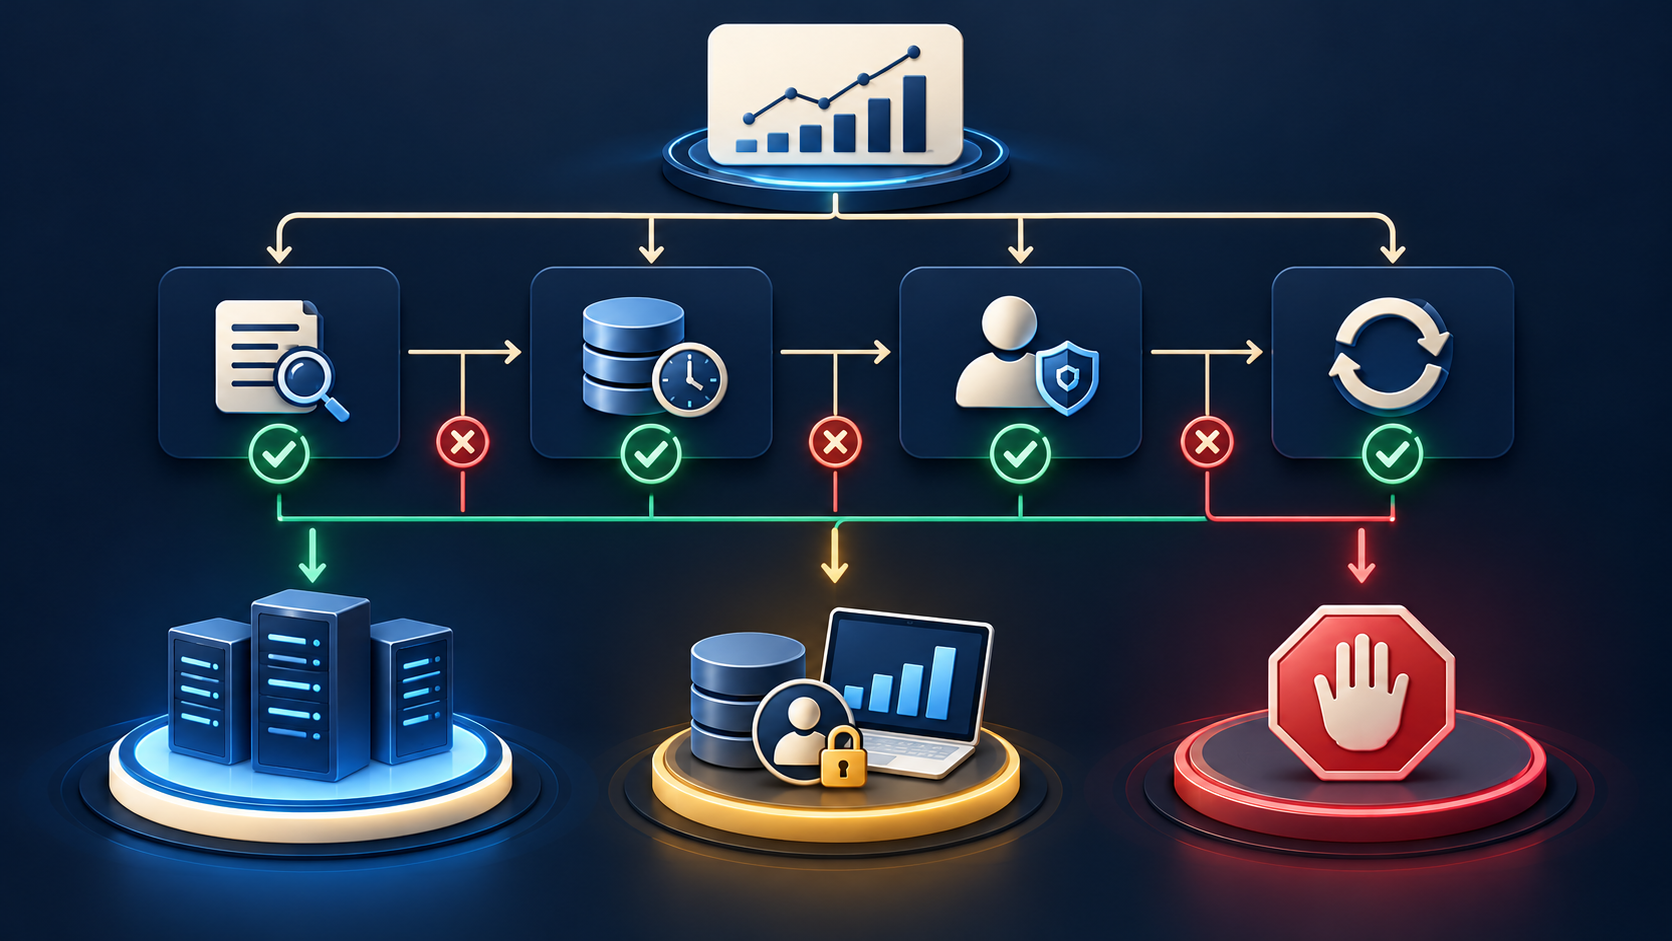
중앙화·제한 파일럿·보류를 고르는 기준
| 상태 | 보이는 증거 | 다음 행동 |
|---|---|---|
| 중앙화 검토 가능 | 6칸이 채워졌고, 반복 비교에서 허용 오차 안에 들며, 담당자와 복귀 절차가 확인됨 | 도메인을 하나씩 늘리되 매 KPI마다 같은 카드를 유지합니다. |
| 제한 파일럿 | 핵심 정의·결과는 맞지만 freshness, 비용, 운영 알림의 증거가 아직 짧음 | 읽기 전용·한 KPI·한 도메인으로 기간을 정해 관찰합니다. |
| 즉시 보류 | 정의·시간대·소유자가 없거나, 허용 오차 초과, 권한 범위 설명 불가, rollback 부재 | 조회 범위를 넓히지 말고 기준 리포트를 유지한 채 빈 칸부터 해결합니다. |
숫자가 어긋났을 때는 이 순서로 분리하세요
불일치가 생겼을 때 “연합 조회는 믿을 수 없다”고 바로 결론 내리면 원인을 놓치기 쉽습니다. 다음 순서로 좁혀 보세요.
- 정의·grain·필터·시간대가 같은지 확인합니다.
- 원본 도착, metadata refresh, snapshot, 조회 시각이 같은 기준선을 가리키는지 확인합니다.
- 읽기 권한이 필요한 행·열을 누락하거나 과도하게 열지 않았는지 확인합니다.
- 실행 비용과 오류 로그를 담당자가 볼 수 있는지, 기준 리포트로 즉시 돌아갈 수 있는지 확인합니다.
Google Cloud의 Lakehouse runtime catalog 문서도 카탈로그가 테이블 메타데이터를 다루고, 저장소에는 별도의 메타데이터·데이터 파일이 놓이는 계층을 설명합니다. 이 구조를 이해하면 데이터 이동 여부와 숫자의 의미를 한 문제로 뭉뚱그리지 않게 됩니다.
파일럿 전에 확인할 짧은 체크리스트
- 기준 KPI의 정의·grain·필터·시간대·담당자를 고정했나요?
- 원본·기존 리포트·연합 조회의 동등 기간 결과와 허용 오차를 기록했나요?
- snapshot 또는 metadata refresh와 데이터 도착 지연을 기록했나요?
- 읽는 namespace·table·column과 자격증명 경계를 확인했나요?
- 실행 비용·실패 로그·알림 담당자와 rollback을 정했나요?
- 한 도메인·읽기 전용·한 KPI로만 시작했나요?
도입의 첫 목표를 “더 많은 데이터를 보게 하기”가 아니라 “한 숫자를 다시 설명할 수 있게 하기”로 두세요. 비용, 권한, 신뢰성, 운영 책임이 함께 남아야 다음 도메인으로 넓힐 근거가 생깁니다.
다음으로 읽어볼 글
- 파일럿 이후 데이터 에이전트의 접근 범위를 넓히기 전에 볼 지표
- 질문별 실행 비용과 실패를 남기는 데이터 에이전트 원장
- 생성된 데이터 파이프라인 변경을 수용하기 전 확인할 기준
- 분석 답변을 사람에게 넘길 때 근거를 정리하는 방법
자주 묻는 질문
연합 조회는 언제 중앙 복제보다 나은 선택인가요?
데이터 이동을 줄이는 이점만으로 고르기보다, 한 KPI의 정의·결과·freshness·권한·비용·복귀 조건을 검증할 수 있을 때 제한적으로 검토하는 편이 좋습니다. 반복 비교가 안정적일 때에만 범위를 넓히세요.
숫자가 한 번 같으면 파일럿을 끝내도 되나요?
아닙니다. 한 번의 일치는 우연히 같은 snapshot과 조건을 봤다는 뜻일 수 있습니다. 적어도 정해진 기간과 조건에서 반복 비교하고, 불일치 행을 조사할 수 있는 기록을 남기세요.
메타데이터 동기화가 되면 실제 데이터도 최신인가요?
그렇다고 단정할 수 없습니다. metadata refresh 또는 snapshot 시각과 원본 데이터 도착 시각, 실제 조회 시각을 각각 확인해야 합니다.
짧은 수명의 자격증명을 쓰면 권한 검토는 생략해도 되나요?
아닙니다. 자격증명의 수명과 접근 범위는 다른 문제입니다. 필요한 namespace·table·column만 읽도록 했는지, 누가 중단할 수 있는지를 별도로 확인하세요.
에이전트가 자연어로 쿼리를 만들면 이 카드는 필요 없나요?
오히려 필요합니다. 자연어 요청을 실행 가능한 쿼리로 바꾸는 과정이 편해져도, 그 결과가 기존 KPI와 같은 의미인지와 운영상 허용 가능한지는 별도로 검증해야 합니다.
참고 자료
- Google Cloud Blog — Cross-cloud conversational analytics made simple with open standards: 외부 카탈로그 메타데이터 동기화와 제자리 분석 사례를 설명합니다.
- Google Cloud Documentation — About the Lakehouse runtime catalog: 카탈로그·메타데이터·저장소 계층과 Iceberg REST Catalog API를 설명합니다.
- Google Cloud — Data Agent Kit: 에이전트가 데이터 작업·쿼리·파이프라인을 수행하는 사용 맥락을 확인할 수 있습니다.
- dbt Developer Hub — Add data tests to your DAG: 실패 행을 찾는 assertion 기반 데이터 검증 방식을 설명합니다.
이 글이 마음에 드세요?
FLOWIT on YouTube
영상으로도 FLOWIT을 이어서 보세요
AI 자동화, Claude Code, n8n, 데이터 분석 흐름을 블로그와 영상으로 함께 정리하고 있습니다.
Related Notes
같이 읽으면 좋은 FLOWIT 글
 GitHub Actions 재사용 워크플로, YAML 중복만 보고 묶지 마세요여러 저장소의 CI를 reusable workflow로 묶기 전, caller·called 권한·비밀값·참조·검증 책임을 6칸 카드로 점검해 중앙화·파일럿·보류를 결정하는 방법을 정리합니다.
 AI 코딩 에이전트 의존성 변경, 병합 전 6칸 판단표AI 코딩 에이전트 PR에서 manifest·lockfile·GitHub Actions 참조가 함께 바뀌었을 때, 테스트 통과와 별도로 병합·추가 확인·보류를 결정하는 6칸 판단표를 정리합니다.
 AI 데이터 에이전트, 잘 쓰는 사람이 늘면 바로 확대해도 될까? 접근 범위를 여는 5지표 게이트AI 데이터 에이전트 파일럿의 사용자가 늘었을 때 사용자·데이터 범위를 확대할지 판단하는 5지표 운영표와 실패 조건을 정리합니다.