한 줄 답: 중앙 정책을 배포했다는 사실만으로는 충분하지 않습니다. 정책 버전, 각 IDE의 적용 구성, 허용·차단 시험 결과, 필요한 관측 기록을 한 묶음으로 남겨야 실제 적용 상태를 판단할 수 있습니다.
관리자가 MCP 허용 목록, 플러그인 제한, 승인 우회 차단을 배포한 뒤 가장 중요한 질문은 하나입니다. 개발자 각자의 IDE에서도 같은 정책이 실제로 적용됐는지 무엇으로 확인할 수 있을까요?
이 글은 GitHub Copilot Enterprise처럼 중앙 관리 기능을 쓰는 팀을 위해, 설정 파일의 존재와 실제 적용 상태를 구분하는 방법을 정리합니다. 목표는 특정 제품 기능을 나열하는 일이 아니라, 정책 변경 뒤 배포를 확대해도 되는지 결정할 수 있는 증거를 남기는 것입니다.
핵심 요약
- 정책 선언은 출발점일 뿐이며, 완료 기준은 각 클라이언트에서 관찰한 effective state입니다.
- 검증은 MCP, 플러그인·마켓플레이스, 승인 우회·Autopilot, 관측 설정의 네 면으로 나누면 누락을 줄일 수 있습니다.
- 허용 동작 하나와 거부 동작 하나를 분리한 canary 시험이 있어야 “보이는 설정”과 “작동하는 통제”를 구별할 수 있습니다.
- 한 면이라도 기대 결과와 다르면 배포 확대를 멈추고, 대상·버전·예외 승인을 기록한 뒤 다시 확인해야 합니다.
정책 선언과 실제 적용 상태는 왜 다른가요?
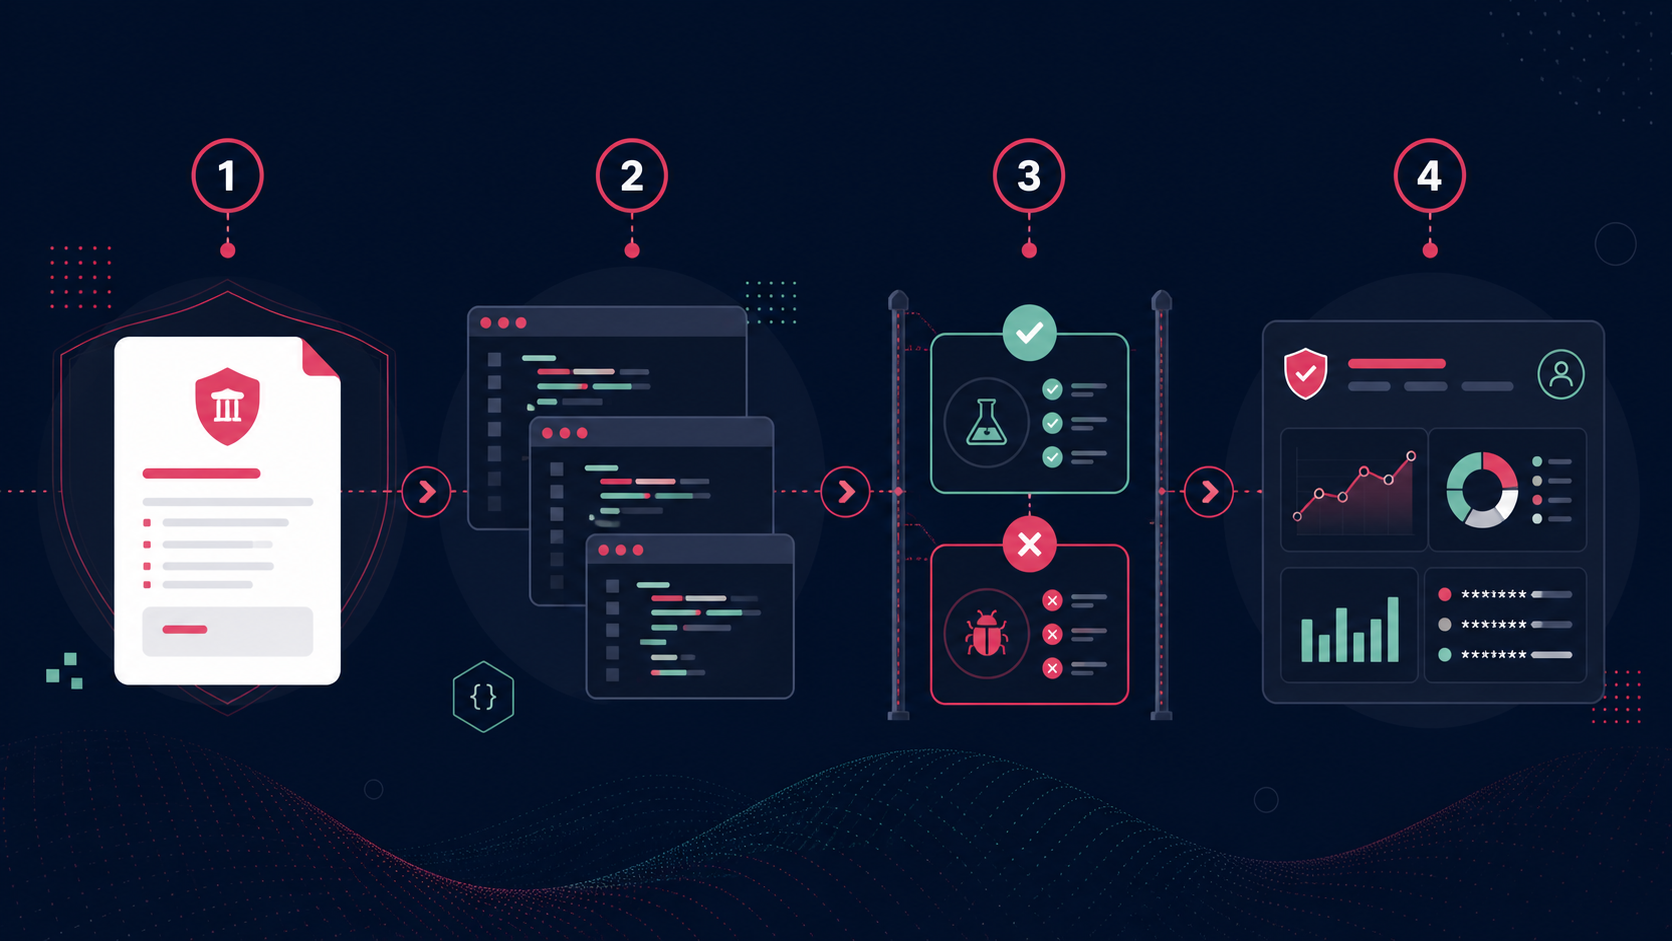
정책 선언은 관리자가 어떤 값을 의도했는지 보여줍니다. 반면 실제 적용 상태는 특정 사용자, 특정 IDE와 플러그인 버전, 특정 시점에 그 의도가 실제로 강제됐는지를 뜻합니다. 둘 사이에는 클라이언트 업데이트 지연, 지원 범위 차이, 조직별 예외, 잘못된 배포 대상 같은 변수가 끼어들 수 있습니다.
GitHub는 2026년 8월 JetBrains용 GitHub Copilot에서 엔터프라이즈 관리 설정으로 플러그인, 허용·거부 MCP 서버, 중앙 OpenTelemetry 구성, Bypass Approvals 및 Autopilot 관련 제어를 다룰 수 있다고 안내했습니다. 다만 지원 설정과 클라이언트 범위는 계속 달라질 수 있으므로, 적용 전에 관리 설정 레퍼런스와 해당 IDE의 지원 상태를 다시 확인해야 합니다.
effective-state 증거 카드: 배포 뒤 남겨야 할 최소 기록
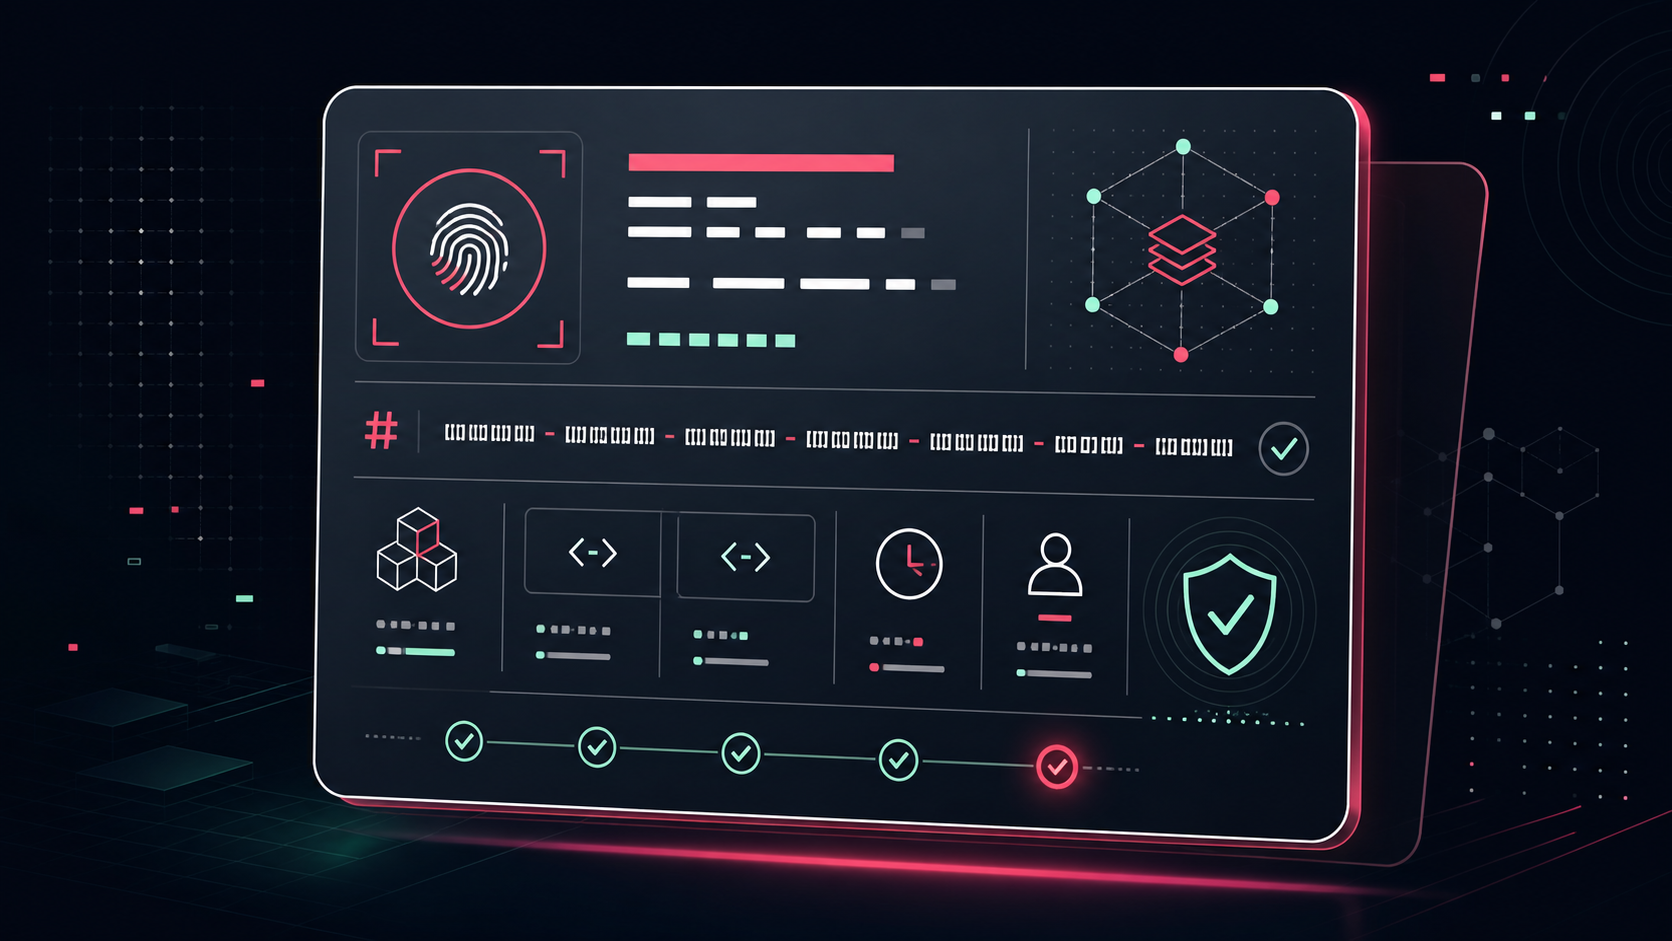
증거 카드는 거대한 감사 문서가 아닙니다. 변경 한 건을 판단 가능한 단위로 압축한 기록입니다. 운영 담당자와 보안 담당자가 서로 다른 화면을 보더라도 같은 사실을 확인할 수 있게 만드는 것이 목적입니다.
- 정책 식별: 변경 ID 또는 해시, 적용 대상 엔터프라이즈·조직, 변경 소유자를 기록합니다.
- 클라이언트 식별: IDE 이름·버전, Copilot 플러그인 버전, 테스트 계정 또는 역할을 기록합니다.
- 적용 시각: 정책 배포 시각과 클라이언트가 다시 읽은 시각을 구분합니다.
- 행동 증거: 허용된 동작과 거부돼야 할 동작의 결과를 링크 또는 짧은 로그 식별자로 남깁니다.
- 관측 경로: 필요한 운영 신호가 도착하는지만 확인하고, 코드·프롬프트·비밀값을 과도하게 모으지 않습니다.
네 정책 면을 어떻게 시험하나요?
모든 설정을 한 번에 확인하려고 하면 실패 원인을 분리하기 어렵습니다. 정책 면마다 기대 결과와 중단 조건을 정해 두면, 제한이 풀렸는지 또는 정상 사용까지 막혔는지를 빠르게 구분할 수 있습니다.
| 정책 면 | 기대 상태 | 확인 증거 | canary 시도 | 중단 조건 |
|---|---|---|---|---|
| MCP allow/deny | 허용 서버만 연결됩니다. | 정책 버전과 연결 결과 | 허용 1건·거부 1건 연결 | 거부 서버가 연결되거나 허용 서버가 이유 없이 막힐 때 |
| 플러그인·마켓플레이스 | 승인된 확장만 설치·활성화됩니다. | 클라이언트 버전과 설치 결과 | 허용·제한 확장 각각 시도 | 제한 확장이 설치되거나 업무 필수 확장이 차단될 때 |
| 승인 우회·Autopilot | 조직이 정한 승인 경계가 유지됩니다. | 역할별 실행 결과와 정책 식별 | 별도 테스트 계정으로 우회 시도 | 차단돼야 할 경로가 실행되거나 역할별 결과가 뒤섞일 때 |
| OpenTelemetry | 허용된 운영 신호만 지정 경로로 전달됩니다. | 엔드포인트·수집 범위 확인 | 비민감 시험 작업 1건 실행 | 신호가 전혀 없거나 범위를 넘는 데이터가 보일 때 |
표는 모바일에서 좌우로 밀어 확인하세요.
이 표는 GitHub가 안내한 관리 설정 범위를 운영 시험으로 번역한 것입니다. 실제 키와 지원 클라이언트는 GitHub 변경 이력 및 공식 레퍼런스를 기준으로 팀 환경에서 재확인해 주세요.
재현 가능한 canary 검증: 한 번에 넓히지 않는 이유
전체 조직에 먼저 적용한 뒤 문의를 모으는 방식은 권한과 생산성 문제를 동시에 키울 수 있습니다. 역할이 분리된 소수 계정과 대표 IDE 조합으로 작은 시험을 먼저 수행하면, 정책·클라이언트·계정 예외 중 어느 층에서 문제가 생겼는지 좁힐 수 있습니다.
- 대상을 고릅니다. 대표 IDE와 플러그인 버전, 일반 개발자 역할과 제한 역할을 최소 하나씩 선정합니다.
- 허용 사례를 실행합니다. 승인된 MCP 서버 연결처럼 정상 업무에 필요한 동작이 되는지 확인합니다.
- 거부 사례를 실행합니다. 거부된 MCP 서버, 제한된 확장, 승인 우회 경로를 각각 분리해 시도합니다.
- 기록을 연결합니다. 각 결과를 정책 식별·클라이언트 버전·실행 시각과 같은 증거 카드에 붙입니다.
- 확대 여부를 결정합니다. 모든 면에서 기대 결과가 일치할 때만 다음 대상군으로 넓힙니다.
불일치가 발견됐을 때의 중단·복구 기준
드리프트가 곧바로 악의적 행위를 뜻하지는 않습니다. 제품 업데이트, 정책 전파 지연, 조직 예외도 원인이 될 수 있습니다. 그러나 쓰기·삭제·외부 전송처럼 영향이 큰 작업은 원인이 확인되기 전까지 확대하지 않는 편이 좋습니다.
1. 확대를 멈춥니다
영향받은 IDE·플러그인·역할 조합을 분리하고, 새로운 대상군으로의 배포를 보류합니다.
2. 사실을 고정합니다
정책 해시, 대상, 클라이언트 버전, 시험 결과, 담당자를 저장합니다. 민감 원문은 필요한 범위만 마스킹합니다.
3. 예외와 결함을 구분합니다
승인된 예외인지, 지원 범위 차이인지, 잘못된 적용인지 확인합니다. 예외라면 만료 시점과 책임자를 함께 남깁니다.
4. 수정 뒤 같은 시험을 반복합니다
수정 후에는 성공 사례만 보지 말고, 반드시 거부 사례까지 같은 canary 조합에서 다시 확인합니다.
정책 적용 뒤에도 실제 도구 호출의 기준선을 살피는 방법은 AI 에이전트 스킬의 실행 중 행위 드리프트 점검표에서 이어서 볼 수 있습니다. 설치 전 확장 수용 판단은 에이전트 스킬 설치 전 게이트, 관측 데이터의 수집 범위와 접근 원칙은 텔레메트리 점검표와 함께 검토해 보세요.
자주 묻는 질문
Q. 정책 파일이 배포됐다는 기록만으로 충분하지 않나요?
A. 충분하지 않습니다. 정책 파일은 의도된 값을 보여줄 뿐, 특정 IDE·플러그인·계정 조합에서 실제로 읽히고 강제됐다는 증거는 아닙니다. 최소한 허용·거부 시험 결과를 정책 식별과 함께 남겨야 합니다.
Q. 모든 개발자 IDE를 매번 시험해야 하나요?
A. 대표 조합을 기준으로 시작하되, 지원 범위가 다른 IDE나 플러그인 버전은 별도 조합으로 관리하는 편이 좋습니다. 새 클라이언트 지원, 정책 키 변경, 플러그인 대규모 업데이트는 재검증의 계기가 됩니다.
Q. 예외 승인은 어디에 남겨야 하나요?
A. 정책 변경 기록과 연결되는 곳에 대상, 사유, 승인자, 만료 시점, 재검증 조건을 함께 남기세요. 구두 예외는 다음 정책 변경 때 재현하기 어렵습니다.
Q. 관측 기록에 코드나 프롬프트를 모두 저장해야 하나요?
A. 아닙니다. 적용 여부를 판단하는 데 필요한 범위부터 정하고, 비밀값·개인정보·업무 원문은 조직의 데이터 처리 원칙에 맞춰 최소화하고 마스킹해야 합니다.
마무리: 배포 완료가 아니라 판단 가능한 상태를 만드세요
AI 코딩 에이전트 정책은 한 번의 설정 작업으로 끝나지 않습니다. 정책 버전, IDE 적용 구성, canary의 허용·차단 결과, 필요한 운영 기록을 함께 묶으면, 팀은 “배포했다”가 아니라 “이 조합에서 실제로 적용됐음을 확인했다”고 말할 수 있습니다. 이 차이가 권한·신뢰성·운영 품질을 함께 지키는 가장 작은 출발점입니다.
출처와 추가 확인 자료
- GitHub Changelog — Enterprise managed settings in GitHub Copilot for JetBrains: JetBrains용 Copilot에서 관리 설정으로 다룰 수 있는 정책 범위를 확인한 1차 변경 이력입니다.
- GitHub Docs — Enforcing policies for GitHub Copilot in your enterprise: 엔터프라이즈와 조직 범위에서 정책을 강제하는 기본 구조를 확인하는 공식 문서입니다.
- GitHub Docs — Enterprise managed settings reference: 지원 설정 키와 지원 클라이언트·배포 문서를 최신 상태로 재확인할 때 쓰는 공식 레퍼런스입니다.
이 글이 마음에 드세요?
FLOWIT on YouTube
영상으로도 FLOWIT을 이어서 보세요
AI 자동화, Claude Code, n8n, 데이터 분석 흐름을 블로그와 영상으로 함께 정리하고 있습니다.
Related Notes
같이 읽으면 좋은 FLOWIT 글
 Markdown으로 만든 AI 자동화, 바로 Actions에 올려도 될까? 6칸 실행 경계 카드Markdown으로 정의한 AI workflow가 GitHub Actions에서 실행될 때 무엇을 읽고·바꾸고·외부로 전달하는지 배포 전에 검토하는 6칸 실행 경계 카드를 정리합니다. 최소 권한, 비밀값, 산출물 소비자,…
 AI 데이터 에이전트의 ‘검증된 질문’, 지표가 바뀌어도 믿어도 될까? 6칸 변경관리 카드AI 데이터 에이전트의 검증된 질문과 SQL은 지표 정의·조인 규칙·반품 처리·기간 경계·시간대가 바뀌면 만료될 수 있습니다. 질문별 영향 판정, 재검증, 보류와 재승격을 운영하는 6칸 변경관리…
 AI 에이전트 도구 자동 실행, 어디까지 맡겨도 될까? 3단계 canary 카드AI 에이전트와 MCP 도구의 자동 실행을 바로 허용하기 전, shadow·제한 auto·pause/deny 3단계 canary와 승격·롤백 기준을 정리합니다.